博客

  • 最好的告别:关于衰老与死亡,你必须知道的常识

    评论

    • 作者认为的进步应该是指在经济发展的阶段里,老人拥有更多财富,从而拥有更多选择。

    这实际上代表着一种极大的进步,老年人的选择显著增加。

    • 作者的逻辑思路好清晰啊,从老人提到岳母的母亲和祖父,然后提出两种老人的生活方式,进而提出老而独立生活是社会的进步,最后再问出独立生活中丧失独立能力怎么办。
    • 生存矩形化是指原本5岁小孩的人口应该多于年龄大的人,但如今50岁和5岁小孩人口相当,这样的人口结构会带来复杂的人口问题,是人类迄今为止没有遇见过的问题。
    • 年老以后能做的事情很有限,照顾另一半承载了一部分自我价值。

    他并不觉得这份责任是一个负担。随着他个人生活的内容变窄,照顾贝拉的能力成了他的自我价值来源。

    • 看到不知道差点哭出来,面对衰老和死亡人是那么无助。

    我问他,如果右耳听力再次丧失,或者发生类似的灾难,他怎么办。他说不知道。

    • 无能为力的难过真的是能把我戳融化

    一旦衰老导致衰弱,似乎就没人可以活得快乐。

    • 辅助生活的概念其实不是多么先进,只是给了老人自尊。大多福利院养老院都是流程化的安排行程和时间,老人们去适应养老院的习惯。看了书,我想象中的辅助生活是我自己生活,但是有公共的外卖小哥,护士,之类的。
    • 没有考虑到死亡将近的时候,活在未来的时候,马斯洛模型是起作用的。但当意识到死亡是活着的一部分的时候,马斯洛模型是失效的,人只是想活在当下。
    • 年老之后独立和安全是对立的
    • 存在主义认为存在本身就没有意义,死亡是活着的一部分,也本身便没有意义。荒诞主义又认为说寻求意义的人生本是广泛的…
      有点跑偏书中的主题,但联想到了记一笔。

    唯一让死亡并非毫无意义的途径,就是把自己视为某种更大的事物的一部分:家庭、社区、社会。

    • 从社会机器运作的角度来说,这样做真的很合理,就是太缺乏人性了。

    在非洲,一旦人老了,不能干活了,人们就会把他扔到丛林里,给野兽吃掉。

    • 接受临终治疗的家庭在患者离世后抑郁症都能降低!

    摘抄

    1. 在人近黄昏之时,所需的不仅仅是医药,还有生活——有意义的生活,在当时情形下尽可能丰富和充分的生活。
    2. 即使到了高年资阶段,他依然认为医学中最大的困惑还是不确定性。病人因为无法确诊而惶恐不安,医生因为不能确诊而左右为难,医疗费用因为不确定性的探究而节节攀升,社会舆论因为不确定性而质疑医学的科学性。
    3. 电脑仪以20%的优势击败资深专家。几乎在所有的竞赛中,电脑要么与人类战平,要么胜过人类。或许数码医疗的前景是水火不容,不是相辅相成。
    4. 在他看来,医生需要掌握的知识在容量和复杂程度上已经大大超出了个体所能承载的极限,根本就没人能全部掌握并理解这些知识。结果,医生和科学家们的分工越来越细微、越来越专业化。如果我无法处理13600种疾病,那好,也许50种我可以应付得来——或者至少有一种疾病是我主攻的。
    5. 医生变成了一位专家,关心的只是自己专业范围之内的事,而医学能否让整个医疗系统更好地造福人类这一层次的问题,渐渐不在我们的考虑范畴之内。
    6. 对于每个接受脾脏摘除手术的病人来说,疫苗必须打,因为疫苗会帮助对抗侵犯人体的三种病菌。外科医生以为ICU医生会打,ICU医生以为初级护理师会打,而初级护理师以为外科医生已经打过了,大家都忘了。
    7. 事实证明,救治失败并不是医学的无能,而是对生命进程的尊重。
    8. 应该如何优雅地跨越生命的终点?对此,大多数人缺少清晰的观念,而只是把命运交由医学、技术和陌生人来掌控。
    9. 到那一天,生的愉悦与死的坦然都将成为生命圆满的标志。
    10. 历史的发展轨迹非常清楚:一旦人们拥有告别传统生活方式的足够的资源和机会,他们就会义无反顾地拥抱新生活。
    11. 有趣的是,随着时间的推移,老年人似乎并不特别为孩子的离开而难过。历史学家发现,在工业化时代,老年人大多没有经济上的困难,他们并不为独自生活而难过。相反,随着经济的发展,财产权模式也发生了改变。子女离家去外地找寻机会,那些长寿的父母发现他们可以卖掉土地而无须把土地传给孩子。工资上涨和退休金制度使得越来越多的老人得以积攒存款和财富,从而使他们能够在经济上安排好自己的老年生活,无须一直劳作到死。
    12. 20世纪初,65岁以上的美国人中,60%与一个孩子同住;而到了60年代,这个数字已经下降到25%;到1975年,则已只有15%。这个趋势席卷世界。年过80的欧洲人只有10%与子女同住,大约一半的人完全独居,没有伴侣。
    13. 与其说老年人丧失了传统的地位和控制权,不如说他们分享了新的地位和控制权。现代化并没有降低老年人的地位,而只是降低了家庭的地位。
    14. 当独立、自助的生活不能再维持时,我们该怎么办?
    15. 现在,世界上多数地方人们的平均寿命已经超过了80岁,所以可以说,我们已经是怪物,我们的寿命远远超出了给定的时间。当我们研究衰老时,我们试图理解的并不是自然的过程,而是非自然的过程。
    16. 医生的工作是维护病人的生命质量。这包含两层意思:尽可能免除疾病的困扰,以及维持足够的活力及能力去积极生活。
    17. 我们体内的最后一个备用系统失灵之前,医学护理可以决定这条道路是猛然下降,还是舒展平缓地下降,使我们可以更长久地保持至关重要的生活能力。
    18. 它要求我们每个人思考我们生活中不可以治愈的情况——我们将面对的不可避免的衰老,以便作出一些必要的小小改变来重塑衰老。在长生不老的幻觉大行其道的情况下,老年病学医生要求我们承认自己会衰老,这个举动很不讨巧。
    19. 我已无法一边想事情,一边穿衣服,同时确定衣服已经完全穿好。
    20. 他并不觉得这份责任是一个负担。随着他个人生活的内容变窄,照顾贝拉的能力成了他的自我价值来源。
    21. “老年不是一场战斗,而是一场屠杀。”
    22. 人们可以在很长一段时间内掌控自己的生活。但是,最终所有的丧失会累积到一个点
    23. 她需要的远远超出了他能给予的。
    24. 疗养院的创办从来不是为了帮助人们面对高龄的依赖问题,而是为了给医院腾床位。
    25. 我们一半的人都会在此度过一年以上生命的地方从来就不是真正为我们修建的。
    26. 老了但对生活的要求不能仅仅是安全
    27. 在我们衰老脆弱、不再有能力保护自己的时候,如何使生活存在价值。
    28. 我们想象不出,在我们衰老、脆弱、没人帮助就无法生活的情况下,还可能有什么更好的选择。我们想不出更好的方案。
    29. 一旦衰老导致衰弱,似乎就没人可以活得快乐。
    30. 人生的动力并不是恒定的,而是随着时间的变化,以与马斯洛经典的层次理论并不十分吻合的方式发生着巨大的变化。
    31. 如果随着年龄的增长,我们从在意实现、拥有和得到转而懂得欣赏日常生活的愉快和亲密关系,如果我们发现这更具满足感,那么,为什么我们要等这么久才去做?为什么我们要等到老了才去做?生活是一种技能。老年的平静和智慧是在时间历程中实现的。
    32. 我们如何使用时间可能取决于我们觉得自己还有多少时间。
    33. 但随着你的视野收缩,当你开始觉得未来是有限的、不确定的时候,你的关注点开始转向此时此地,放在了日常生活的愉悦和最亲近的人身上。
    34. 当“生命的脆弱性凸显出来”时,人们的日常生活目标和动机会彻底改变。
    35. 既能保证隐私又能提供充分服务的机构允许衰弱的老年人留住下来。
    36. 他是不是瘦了,是不是忘了吃药了,或者是不是摔倒了;而不是他是不是孤独。
    37. 辅助生活机构不是为老年人修建的,而是为他们的子女修建的。实际上,决定老年人住哪里的是儿女,这从养老院的销售方式就看得出来。
    38. 我们希望给予我们关心的人的许多东西,是我们自己强烈拒绝的,因为它们影响我们的自我感受。
    39. 我们的老年人过着一种受控制、受监督的机构化的生活。这是医学为不可医治的问题设计的解决办法,一种能保证安全,但是没有他们所关心的内容的生活。
    40. 疗养院的三大瘟疫:厌倦感、孤独感和无助感。
    41. 文化是共享习惯和期望的总和。
    42. 针对厌倦感,生物会体现出自发性;针对孤独感,生物能提供陪伴;针对无助感,生物会提供照顾其他生命的机会。
    43. 他们在生命的每一个阶段都可能遭遇死亡。但这也引出了一个艰难的问题:什么时候应该努力医治,什么时候应该放弃治疗?
    44. 最终,死亡还是不期而至,却没有几个人懂得什么时候停止治疗最为理想。
    45. 问题不是我们如何能够承担这个系统的开支,而是怎样建立一个系统,能够在人们生命终结之时,帮助他们实现其最重要的愿望。
    46. 普通医疗的目标是延长生命。为了有机会获得未来时间,现在,我们要牺牲你的生存质量——通过手术、化疗、把你送到监护室。而善终服务是让护士、医生、牧师以及社工帮助致命疾病患者在当下享有可能的最充分的生活
    47. 善终服务试图提供一种死亡方式的新范式。虽然并不是每个人都接受其主张,但是,那些接受的人在为我们这个时代展现一种死亡艺术。
    48. 只有不去努力活得更长,才能够活得更长。
    49. 你不是在决定他们是需要A治疗方案还是B治疗方案,而是想努力了解在这种情况下,对他们来说,什么最重要
    50. 洛克认为,如果不是为了满足所爱的人的希望,2/3的病人宁愿放弃他们不想做的治疗。
    51. 全球10个增长最快的经济体有5个在非洲。
    52. 80岁以上的老人有一半在医院里过世,而80岁以下的人群中,在医院离世的比例甚至更高。
    53. 一个国家的医疗发展会经历三个阶段:第一个阶段,国家极度贫困,因为得不到专业诊断和治疗,大多数人在家中亡故。第二个阶段,随着国家经济发展,人民收入水平提高,更多的资源使得医疗得到更广泛的提供,患病的时候,人们求助于卫生保健系统。在生命行将结束的时候,他们往往在医院逝世,而不是在家中终了。第三个阶段,国家的收入攀升到最高的水平,即便罹患疾病,人们也有能力关心生命质量,居家离世的比例又增加了。
    54. 要在人的必死性方面谋求共识,并以生命尊严和保持有意义生活作为生存追求,医患双方都面临着学习的任务,
    55. 愿望是反复无常的。
    56. 在某个时刻,医生需要帮病人权衡他们更大的目标,甚至质疑他们,让他们重新思考其考虑失当的优先选项和信念。这种做法不仅是正确的,而且也是必需的。
    57. 癌症致死的方式有很多种,逐渐夺去吃饭能力是其中之一。
    58. 我们三个人加起来总共有120年的行医经验,但是这对我们仍然是一个谜。而结果对我们是一次教育。
    59. 然后她问:“你想用哪一家殡仪馆?”她的问题让我十分震惊——我们真的在谈这个话题吗?看到她坦然的表情,我又觉得安心,这对她原本就是很正常、普通的事情。他毫不犹豫地说:“耶格斯。”我一下意识到,他一直在考虑这件事。我父亲很平静,而我母亲则很震惊——这超出了她预期的轨道。
    60. 把今天过到最好、而不是为了未来牺牲现在
    61. 对于故事而言,结局是最重要的。
    62. 善终不是好死而是好好活到终点
    63. 们在对待病人和老人方面最残酷的失败,是没有认识到,除了安全和长寿,他们还有优先考虑事项;建构个人故事的机会是维持人生意义的根本;通过改变每个人生命最后阶段的可能性这一方式,我们有机会重塑我们的养老机构、我们的文化和我们的对话。
    64. 一个人的生命走到尽头的时候,也就是做决定的责任转移到另一个人身上的时候。
    65. 结尾不仅仅是对死者重要,也许,对于留下的人,甚至更重要

    读后总结

    救治失败并不是医学的无能,而是对生命进程的尊重,医学改变了死亡体验却又无法改变死亡的结局。大多数人都是将临终前命运交由医学、技术和陌生人来掌控,现代医疗对临终的病人更关心的是能不能无痛苦、舒适的走完最后的旅程,并没有关心临终者在世最后一程的生活质量。

    书中讨论了两类情况,一类是丧失自理能力的老人,一类是现代医疗确信大限将至的人。

    衰老

    作者痛批评了大部分医疗院的模式,每天固定时间叫老人们起床穿衣洗漱吃饭,像蹲监狱一样的人生。在年迈,生活无法完全自理的时候,老人依然希望有尊严的活着,通过给与老人个性的选择权和尽职的保护是作者观察到优秀的疗养院和辅助生活给出的答案。

    在疗养院模式下老人们是住进了监狱,听从监狱的一切安排,没有自我没有生活,而疗养院的人可能还认为给出了足够多的“自我”。但作者提出的模式更像是老人们住进了有护理的合租房,老人们想几点起便几点起,意志和个性是可以被保留的,想出去看电影或者爬山都是被允许的,只是需要陪护。

    大限将至

    25%的医疗保险费用花在5%生命处于最后一年的病人身上,最终死亡还是不期而至,没有几个人懂得什么时候停止治疗。

    研究表明因为不治之症而在监护室度过生命的最后日子,完全是一种错误。善终护理是一个看似来反常,但实际更合理的选项。标准医疗的目标是延长生命,为未来争取时间,会牺牲生存质量;善终服务并不关注生命的长短,而是帮助患者在当下享受最充分的生活。

    最后举出了自己父亲癌症的例子,真实又令人动容。

  • TCP拥塞控制算法的实现

    基于对google提出的bbr算法源码阅读的一些学习:

    https://github.com/torvalds/linux/blob/master/net/ipv4/tcp_bbr.c#L39

    并不详细介绍bbr的原理,也不逐行解释

    拥塞接口

    TCP底层的拥塞控制通过若干个定义在TCP层的接口被模块化了,不同的算法就可以直接hook对应需要的回调来实现不同的TCP拥塞控制算法。

    Linux内核机制

    • 内核模块化,通过module_init和module_exit来初始化和卸载一个模块。
    • 模块开发不能使用常规的库函数,例如printf, malloc,需要使用内核提供的:printk, kmalloc。
    • 模块是系统的一部分,所以模块卸载需要自己卸载干净,系统不会帮忙进行回收。
    • 模块内开发不能直接对用户指针的对象取值或者复制,因为那是用户空间的地址,在内核空间会没有映射导致有问题,需要使用put_user给用户空间的内存地址复制。
    • 与上类似的函数还有:copy_to_user,copy_from_user,get_user,put_user。
    • 拥塞控制的结构体是:tcp_congestion_ops,定义了一系列的事件函数,通过hook这些函数实现不同的TCP拥塞控制算法。
    static struct tcp_congestion_ops tcp_bbr_cong_ops __read_mostly = {
        .flags      = TCP_CONG_NON_RESTRICTED,
        .name       = "bbr",
        .owner      = THIS_MODULE,
        .init       = bbr_init,                         // 初始化函数
        .cong_control   = bbr_main,                   // 在拥塞状态下,发包前的回调,用于更新拥塞窗口和传输速度
        .sndbuf_expand  = bbr_sndbuf_expand,        // 返回给tcp_sndbuf_expand使用的乘数
        .undo_cwnd  = bbr_undo_cwnd,                // 损失后cwnd的新值
        .cwnd_event = bbr_cwnd_event,               // 当发生拥塞时的回调
        .ssthresh   = bbr_ssthresh,                   // 返回慢启动的阈值
        .min_tso_segs   = bbr_min_tso_segs,           // 系统sysctl_tcp_min_tso_segs的重写
        .get_info   = bbr_get_info,                   // 获取inet的日志信息
        .set_state  = bbr_set_state,                // ca_state变化前会调用
    };
    
    static int __init bbr_register(void)
    {
        BUILD_BUG_ON(sizeof(struct bbr) > ICSK_CA_PRIV_SIZE);
        return tcp_register_congestion_control(&tcp_bbr_cong_ops);
    }
    
    static void __exit bbr_unregister(void)
    {
        tcp_unregister_congestion_control(&tcp_bbr_cong_ops);
    }
    
    module_init(bbr_register);
    module_exit(bbr_unregister);
    • BUILD_BUG_ON是编译时的检测,为了保证bbr的结构体小于等于内核准备的空间大小。
    • 不同的机器的ICSK_CA_PRIV_SIZE值可能不同,但是编译确定下来还有bbr的空间大小和分布,所以一个系统编译,其他系统也是能够使用的。
    • do_div表示除法函数mod = do_div(x, y),结果存储在x中,余数存储在mod中。
  • 从零开始学布林线指标 读书笔记

    认识布林线指标

    布林线是一种路径指标,利用统计原理,求出股价的标准差,从而确定股价的波动范围及未来走势。

    布林线副图是直接对均线求标准差,然后画两倍均线的图,主图是对Ma求出当前时刻的方差,然后将不同时刻的方差再滑动平均,

    • 布林线指标可以指示股价的支撑与压力位置。
    • 布林线指标可以指示市场或个股的超买与超卖状态。
    • 布林线指标可以指示市场或股价当前所处的趋势。
    • 布林线指标具备通道波状带作用。

    布林线的形态应用

    一般而言,形态可分为3种。

    • 顶部形态。
    • 底部形态。
    • 整理形态。

    对每一个主要形态都有明确的分类,我们在这里简单罗列一下。

    • 顶部形态,分为双重顶、头肩顶、三重顶、复合顶等。
    • 底部形态,分为双重底、头肩底、三重底、复合底等。
    • 整理形态,分为箱形整理、三角形整理、旗形整理、楔形整理等。

    当布林通道呈现出快速收缩的状态,开口开始变小,此时布林线的中轨没有明确的方向,而是呈现出一种横向的走势,这一切都表明股价走势开始变得不明朗,还需要等待进一步的转变。

    如何使用布林通道

    证券分析中有一点特别重要,通道不需要完全对称,但一定要有一个中心点作参考,否则难以构成一个通道。

    均线八大法则:200日均线可以衡量市场强弱,让人们意识到在注重短期交易的同时,也意识到长周期趋势下向好的市场环境。

    道氏理论的划分,趋势分为:

    1. 持续时间1~2年的长期趋势
    2. 持续时间可以维持4~6周的中期趋势
    3. 持续时间仅有1周左右的短期趋势

    利用布林通道对股价长期趋势进行研判的方法很简单,就是利用布林线上轨与中轨的方向来研判后市向好的长期趋势,或者是利用布林线下轨与中轨的方向来研判后市看淡的长期趋势。

    如果股价长期趋势向好,那么布林通道的上轨和中轨会一直保持向上的运行态势,股价也基本会在布林线上轨和中轨构成的上通道运行,很少会跌破布林线中轨。此时强势特征非常明显,股价持续稳定地上涨,投资者应坚决持股待涨或逢低买入。

    如果股价长期趋势看淡,布林通道的中轨和下轨会一直保持向下的运行态势,股价也基本会在布林线中轨和下轨构成的下通道运行,很少会冲破布林线中轨。此时股价弱势特征非常明显,股价缓慢稳定地下跌,投资者应坚决逢高离场或持空仓观望。

    与日线图的快速变化相比,周线图相对而言稳定了许多,其代表的中长期趋势也更加直观与准确。

    布林通道中关于中期趋势研判的技术手段有两种,一种是利用布林线中轨方向来判断中期趋势的好坏,另一种是利用布林线上轨与下轨在股价运行过程中形成的高低点来研判中期趋势。

    %B指标

    按照布林线指标发明人约翰·布林格的话讲,%B指标是表明当前股价在布林线中位置的一个指标,它也是进行交易决策时的关键性指标。

    %B指标的计算公式:

    \frac{p-p_{down}}{p_{up}-p}

    约翰·布林格对%B指标进行了大量的数据测试后,给出投资建议:在常态行情下,当%B指标大于0.9或小于0.3时,都倾向于卖出。

    在市场中,股价会经常性地冲出布林线上轨或下轨,这个时候我们又该如何判断风险或机会呢?经过笔者实战统计,当%B指标大于1.1或小于-0.15时,一般认为股价偏离布林线上轨或下轨过远,随时可能发生回落或反弹的行情。

    %B指标主要的作用有两个:一是帮助投资者分析和识别股价的走势形态;二是为投资者提供决策分析依据。在这个过程中,%B指标主要通过顶背离和底背离的方式识别股价的内在动力。

    带宽指标

    布林线的第2个衍生指标就是带宽指标。带宽英文名称为“Band Width”,带宽指标是根据布林线

    带宽指标公式:(上轨线-下轨线)÷中轨线。上下轨所处的位置计算出来的。

    布林通道扩张与收缩

    在布林通道诸多使用技巧中,以布林通道扩张与收缩形成的“喇叭口”最为有名,这也是布林线指标所独有的技术分析手段。布林通道的扩张与收缩,其实就是股价波动性的大小转换,其中布林通道的上轨与下轨负责为投资者揭示股价即将发生波动的警示信号,而中轨则负责揭示股价未来运行的方向。

    总结

    通道理论是证券分析中较为成熟的理论,其中薛斯通道较为典型。

    布林通道的扩张与收缩是股价即将发生波动的警示信号。

    布林线与K线

    其实K线能反馈出一些信息,但是其实已经是非常少的了,没法反馈出最高最低点的振荡次数。

    按照不同的理解,K线可以分成很多种类。从形态分类,K线可以分为星线、吊线、孕线、包线;从用途分类,K线可以分成反转K线和整理K线;从时间周期分类,K线可以分为日线、周线、月线、年线等。

    从布林线指标的角度出发,我们只需将K线按幅度大小分类即可,因为这样的分类可以区分出K线上涨或下跌的力度,有助于我们更好地使用布林线指标。

    K线的幅度就是K线实体的大小,通常情况下,按幅度可以将K线分成如下几类。

    • 大阳线或大阴线,K线实体幅度大于4%。
    • 中阳线或中阴线,K线实体幅度大于1%而小于4%。
    • 小阳线或小阴线,K线实体幅度小于1%。

    这些K线在技术上有着不同的意义,对投资者的心理也有不同的影响。

    大阳线或大阴线说明主力当天积极参与,投入了大量的资金或筹码间接反映了主力对后市的态度。
    大阳线或大阴线多出现在行情的底部或顶部,起到行情见顶或见底的作用。有时也会出现在行情的中段,对股价变化起到加速的作用。

    中阳线或中阴线表明主力当天参与比较积极,间歇性地投入了一定的资金或筹码在一定程度上反映了主力对后市的态度。
    中阳线或中阴线多出现在行情的中间部分,起到串联行情走势的作用。有时候也会出现在行情的顶部或底部,起到见顶或见底的作用。

    小阳线或小阴线表明主力当天投资比较消极,很少投入资金或筹码不能反映主力对后市的态度。
    小阳线或小阴线多出现在行情的整理部分,起到行情过渡的作用,多数情况下意义不大。有时也会出现在行情的顶部或底部,这个时候就会形成常见的行情见顶或见底的K线形态组合。

    由于布林线上轨往往代表着股价的压力位,所以这个时候如果出现大阳线或者大阴线刺破上轨,那么意味着多空双方的目的很单一,就是想向上发展或者是向下发展,而大K线就代表了这样一种态度,实战中如果遇到类似情况,投资者顺势投资就好了。

    在实战中,当几条中K线连续出现时,完全可以将其看成一条超大的大阳线或者大阴线,如此一来,其技术意义就很明确了。

    这个时候如果空头用中阴线击穿布林线中轨,其技术意义就是引导股价向布林线下轨回落以寻求支撑

    由于中K线力度远远不及大K线,因此来到布林线下轨的中K线尽管有可能会击穿下轨,但已经不能开启一轮短线下跌行情,技术上体现的更多是前期下跌行情的延续,表现的是一种下跌的惯性。此时,布林线下轨的支撑作用得以显现,股价即使能够刺破布林线下轨,也会很快返回到布林通道内。

    在下跌行情中,中阴线触碰下底意味着止跌。

    布林线与成交量

    在他看来,只有50日均量线才能真正有效地反映某一阶段成交量变化。将50日均量线与布林线指标进行搭配,一个可以反映股价走势的基本框架,一个可以描述成交量走势的基本格局,二者相得益彰,相互补充,能够很好地对市场行情予以有效的解读。

    成交量指标的种类其实也很多,归纳起来基本有4类,具体如下。

    • 周期性价格变化指标,以OBV(累积能量线)指标为代表。
    • 周期性成交量变化指标,以PVI(正成交量)指标、NVI(负成交量)指标为代表。
    • 区间结构指标,以MFI(现金流量)指标为代表。
    • 成交量权重指标,以VMACD(成交量平滑异同移动平均线)指标为代表。

    OBV

    对于喜欢中短期趋势的投资者而言,参数为10日的OBV指标完全可以适应投资的需要;对于喜欢中长期趋势的投资者而言,可以将OBV指标参数调整为30日,会有一个很好的效果。

    布林线与成交量

    布林线底部形态与投资者平常提到的形态略有不同,它不是以股价的绝对高低来判断,而是以股价在布林线指标中所处的相对位置进行研判。尽管如此,当布林线与成交量结合后,其研判的方法还是大同小异的。

    底部结构

    双底

    底部结构除了布林线的形态之外,还有交易量在底部会下降,说明抛盘已经开始下降,空头力量萎靡。

    头肩底

    • 构造左肩和头部时成交量可以忽略。
    • 构造右肩时上冲的动作要有适当的成交量放出。
    • 突破形态颈线时必须要有成交量的配合。
    • 如果有回抽,需要成交量萎缩确认;如果没有回抽,则无须确认。

    复合底

    在形态构建完成,股价对颈线展开突破时,我们看到成交量有一定程度的放大,这是形态确认的必要条件,绝不能少。

    顶部结构

    布林线顶部形态也是依据股价与布林线的关系而展开的,其落脚点与股价在布林线指标中所处的位置有关。需要明确的是,由于股价自身有重力,一旦向上推升股价的买盘枯竭,就算没有大的成交量,股价也很容易因为受到自身重力的影响而下落。当顶部形态完成后一旦有成交量进行相应的配合,则股价的下跌速度会更快,这一点是投资者要注意的。

    双顶

    从成交量指标来看,双重顶的形态只有两种,一是后顶成交量小于前顶的成交量;二是后顶成交量大于前顶的成交量。

    跟双底差不多,在冲顶之后成交量萎靡,从成交量看出整体开始无力,多头力量不足。

    头肩顶

    • 左肩的成交量一般而言是最大的。
    • 头部的成交量相比左肩已经有所减少。
    • 右肩的成交量已经明显减少。
    • 突破形态颈线时可以放量,也可以不放量。

    在形成左肩时一切都正常,放大的成交量、上涨的价格都预示着行情非常乐观。左肩后的缩量回落也是正常的,行情不可能永远向上,适当地回落整固是非常有必要的。

    复合顶

    放量,意味着多空双方在这个地方对后市的判断产生了分歧,不管未来结果如何,究竟是哪一方获胜,这个地方堆积的大量筹码注定是未来的强支撑或者强阻力。

    成交量

    布林通道的第2个作用,就是可以根据通道的收缩与扩张来预判股价即将出现的某种异动。如果布林通道之前处在收缩状态,我们可以说股价即将由小波动向大波动转变;反过来,如果布林通道之前处在扩张状态,我们可以说股价即将由大波动向小波动转变。

    2b法则

    2B法则是指在上升趋势中,如果股价已经穿越先前的高点但未能持续,稍后又跌破先前的高点,则趋势很可能发生反转;下降趋势也是如此,只是方向相反。

    布林线与均线

    双均线

    在选择均线周期参数时可以与时间周期结合起来,这样能更充分地反映股价的变动。随着研究的深入,投资者逐渐揭开了时间周期的面纱,这时大家才发现,原来时间周期不是单一存在的,而是多种周期相互作用、相互影响的,大周期里面包含着小周期、小周期又影响着大周期,二者之间存在着倍数的关系,既有共融交汇时的共振,又有独立的时间跨度。正是有了这样的发现并且受到启发,投资者才意识到,选择不同的时间周期并不妨碍对股价进行判断,相反可以从不同角度来观察价格的运行。结合当时的交易制度,投资者开始使用“双均线系统”来观察股价的变化,最有名的就是10日和30日“双均线系统”。

    三均线系统

    5日、10日和20日时间周期的“三均线系统。”

    张卫星独创了实战性非常强并且具有国内股市特色的“三均线系统”,即基于20日均线、120日均线和250日均线的“1250”均线系统。

    随着投资技术的普及,有很多普通投资者往往可以寻找到较好的买点,但关键的问题在于他们把握不住好的股票,只要股价震荡就会被清洗出局,而这个时候,均线通道就可以发挥作用。

    10日均线

    10日均线是很重要、很有名的均线。说它重要,是指10日时间周期是时间周期理论中连接长周期和短周期的一个桥梁。按照现行的交易制度,10日均线代表2个交易周的市场平均成本,基本能反映市场中短周期之间的筹码分布情况。

    主要作用:

    • 与布林线上轨构成股价强势上升通道。
    • 与布林线中轨构成均线通道为股价上涨提供支撑。
    • 与布林线下轨构成股价弱势下降通道。
    • 与布林线中轨构成均线通道充当股价反弹时形成阻力。

    50日均线

    • 50日均线是股价自布林线上轨回落时的支撑线。
    • 50日均线是股价自布林线下轨反弹时的阻力线。

    相比上下轨,50日线是一个支撑点和阻力点,若与上下线。

    需要说明的是,50日均线不管是在日线图还是在周线图中,这种支撑或者阻力作用第1次使用时非常有效,但随着时间的推移,这种效果就会递减,直至最终失效,这是读者需要注意的地方。

    布林线与趋势指标(DMI)

    DMI指标包含两方面的技术特征:一个是多空指标,通过它可以辨识当前的行情是由哪一种力量在主导;另一个就是趋向指标,通过它可以判断当前的行情是否正行进在大趋势当中。

    本质上就是择向和择时。

    DMI指标共有+DI(即PDI,上升动向指标)、-DI(即MDI,下降动向指标)、ADX(平均动向指数)、ADXR(平均动向指数的缓动线)这4个参数值,其中PDI、MDI指标曲线组成多空指标,用来辨识方向;ADX、ADXR指标曲线组成趋向指标,用来判断趋势是否改变。

    与KDJ指标和RSI指标一样,当指标曲线在20线以下时,说明指标处在相对低位;当指标曲线在80线以上时,说明指标处在相对高位。

    当PDI线和MDI线同处50线以下时,如果PDI线快速向上突破MDI线,预示新的主力已进场,股价短期内将大涨。此时如果伴随大的成交量放出,那么更能确定行情将向上,投资者应迅速买入股票。

    当PDI线从上向下突破MDI线(即MDI线从下向上突破PDI线)时,此时不论PDI线和MDI处在什么位置都预示着新的空头进场,股价将下跌,投资者应以短线卖出股票或持币观望为主。

    我们现在选用的指标线是ADX线与ADXR线,这两条指标线共同构成了DMI指标中的趋势作用,就是说它们只负责提示当前行情下趋势的强弱程度,至于多空的方向它们则不管。现在读者应该可以理解了,这里的ADX线上穿ADXR线形成金叉,其背后的含义是上升趋势或下降得到了加强或确认,而不是均线理论中支持股价上涨或下跌的金叉或死叉一类的东西。

    这里我们需要提醒投资者一点,就是指标时间周期选择的问题。在证券分析软件中,系统给出的DMI指标默认参数设置是14、6,之所以如此设置,还是与交易制度有关。最初的交易制度是1周交易6日,毫无疑问,指标中“6”这个参数就代表1周的交易时间。1个月大约有4周,合起来应该是可以交易24日,再加上零散交易日,1个月大概可以交易28日,而半个月恰好就是14日。如果按照现行的交易制度,我们其实应该将参数调整为12、5,但这其实与14、6的时间参数相差不大,因此本书还是按照系统原有的参数予以技术上的说明。

    “再而衰”也好,“三而竭”也罢,至少说明,无论是多头还是空头,力量的释放都不是一个波段就可以完成的。我们在实战中一定要注意这一点,千万不要在一个波段后就贸然进场,不然很容易遭到损失。

    当前的市场,主流交易手段就是趋势交易,而趋势交易的前提就是多空有明确的方向。至于DMI指标中的趋势信号,起到的作用就是告诉我们这种明确的多空信号能持续多长的时间。

    1. DMI指标中ADX线只要上穿ADXR线,都意味着趋势信号的生成。
    2. 趋势信号只是意味着对应的股价走势是明确的趋势行情,没有其他的技术含义。
    3. 趋势信号与股价不存在背离关系。

    布林线与抛物线指标

    抛物线指标

    韦尔斯·王尔德一生发明了许多让后人受益良多的指标,DMI指标如此,SAR指标也是如此。

    如果投资者止损价位设定得过高,那么就有可能在股价正常调整回落时卖出,而卖出后股价却从此展开一轮新的升势,因此错失了赚取更大利润的机会,术语叫“卖飞”;反之,如果投资者止损价位设定得过低,或许根本起不到控制风险的作用。

    韦尔斯·王尔德针对SAR指标还提出了一个补充法则。补充法则有两点:一是当股价靠近SAR指标时,无论是上涨还是下跌,指标可能会出现与原来方向相反的信号,如果这种信号在3个SAR数值以下,就不能认为这是反向开仓信号,此时要结合其他技术指标辅助判断;二是SAR指标对于成交量较大的当前市场上反复活跃的股票的判断较为准确。

    趋势行情最大的“敌人”就是震荡

    股价的高点有很多,但绝对的高点只有一个,因此“不言顶”就是股市中的一句至理名言。

    布林线与分形

    波浪理论

    布林均线工具系统

    至此,作者提出的一系列工具:

    • 布林线(20日均线+方差
    • 布林线的图形顶部和底部结构
    • 成交量
    • 布林均线系统:添加10日+40日均线
    • dmi指标
    • 抛物线(SAR)指标

    感想

    在一般的庄稼股中,当发现巨大的放量上涨,这么大的交易量十之有九是韭菜入场。

    布林线是经典的右侧交易,并不是触碰到两次下轨就是双底,任何K线分析的技术都是如此,还需要结合成交量分析,确定底部结构构建完成才应该买入。因为推动股价的始终不是庄家而是韭菜,庄家只是诱导。韭菜进场就会有明显的放量上涨。

  • 如何读懂财报 读书笔记

    这个是第一次尝试在IPad上做笔记,做起来很舒服,但是想把内容整理出来是个麻烦事儿。

    也就是要么都用同一个手写软件做笔记,要么就不用手写软件做笔记。


  • 中国通史读书笔记

    总结

    历史不是一直是被分为近代史和非近代史嘛,钱老开篇便将历史划分为铜器、铁器、电器和原子能时代,开篇就被震撼到了,钱穆老先生的格局就是在人类大局观上,我们口中的“近代史”只是原子能时期生活的人将自己时代和古代划分开的一个说法。

    然后就进一步想,为什么没有把通信方式纳入呢,原子能跨时代,计算机和无线通信也是跨时代的。我猜可能是这些只是提高了信息交换的速度,改变了获取信息的方式,会极大地改变人类的生活,但信息只是媒介。能推动人类历史的还是核心资料的生产:粮食,能源这些。

    而且,历史原来是一件很主观的事情,历史上发生了什么可以是一件客观的事情,但对这些事情的评价,其结果是偶然的还是必然的,这件事情是极其主观的。

    笔记

    粗体是我自己的感悟,其余皆是摘抄
    序

    中国为世界上历史最完备之国家,其特点有三:一者悠久,二者无间断,三者详密。

    第一篇

    有文字记载以前的历史,叫作史前史

    一般来说,这是第一期的石器时期。这第一期又可分成两个时期:(一)旧石器时期,(二)新石器时期。古人懂得用石头,也不把它磨光削尖,就拿来用,此之谓旧石器;而把石头加以磨光削尖等处理后才加以运用的,便是新石器了。

    开篇就被震惊到,直接跨过了所谓的近代和现代,直接以工具和能源的使用划分历史时期。

    第二期便是铜器时期。此时期已有文字。
    第三期则是铁器时期。铁之发现是在铜器之后。
    第四期是电器时期。
    第五期是原子能时期。使用原子能是人类历史的新观点。

    第二期便是铜器时期。此时期已有文字。第三期则是铁器时期。铁之发现是在铜器之后。第四期是电器时期。第五期是原子能时期。使用原子能是人类历史的新观点。

    第七章 春秋时期

    故今日需要有一个人出来讲一句话打开时代的僵局。只要能发明一句,便是大政治家。

    第三篇

    旧势力崩溃,新势力平民阶级兴起,故秦统一中国,并非打倒六国,乃是平民社会希望统一。故汉朝是新兴的平民政治,这就是古代封建社会结束了。

    第十章 西汉时期

    汉高祖刘邦以平民为天子是中国历史上的创举。

    汉高祖刘邦再行封建,此乃为了巩固政权。此举汉高祖实不如秦王高明。

    管不到的人和地方就有封建势力。

    读书人带兵是理想,但带兵人做领袖则不合理想。秦相李斯是文人,故秦始皇是大政治家。秦始皇虽然只做了十三年,但历史不能以成败论英雄,失败的并不一定是不好。汉高祖的王朝长久,这是历史的大趋势。

    第十三章 东汉之士风

    曹操对下属说:“各为其主,不要追他。”这就是曹操为人的优点。小说上关羽过五关斩六将是假的。

    第十四章 东汉末年

    曹操之所以不能统一中国,纯因众人不服所致。

    第四篇

    佛有“佛、法、僧”三宝,“佛”指已死的,“法”指道理,“僧”是指生的人。

    如照基督教讲法,“佛”是上帝,“法”是耶稣,“僧”是牧师。

    如诸葛亮,是琅琊人

    诸葛亮逃到襄阳隆中,但其兄弟一在吴,一在北方跟从曹操,均是了不起的人物。

    中国今日之社会少了一个封建,无团结之庄园,故受人欺辱,因为是分开的、个人的,故吃了不封建的亏。今日中国社会只有政治势力,并无封建势力了。

    第十六章 北朝

    满、蒙族人,跑进中国,均代表其各自的政权,故称部落政权,我们当他们是兄弟,但他们没有把我们当兄弟。

    第十七章 五胡汉化

    魏孝文帝的理想并不错,但为时只有五年,后人只学到生活的享受,却没有学到孔孟之道。今日我们学欧洲人的长处是可以的,但只学到坐汽车、穿西装、吃西餐,却是太肤浅了,应该同时学习他们优秀的地方才好。

    隋代在中国最富,赋税也最轻。只要乡里中有一线,便是一光明,一扬开,光明就来了,谓之一线曙光。

    第十九章 宗教信仰

    印度气候暖,觉天地丰富,故信仰多神;阿拉伯是海边沙漠,觉天地很简单,故选一神教。宗教之缘起,实由环境不同而生。

    耶稣说:上帝的事上帝管,恺撒的事该恺撒管

    任何人生理论哲学,先要人生无意义,才可入门。大家希望的有什么价值呢?要取消一般人的想法。人忙的是什么?

    天亦有轮回,诸天听释迦讲法,如何超出轮回,即取消作业,并非要不朽,要永生,看世界皆空,最好不要做什么,慢慢消业,最后业完。不再轮回,摆脱社会,入空门,什么都不做,这是小乘佛教。取消轮回,叫涅槃。

    第五篇

    中国以汉、唐两代最好。汉代之前有短的秦朝十五年,唐代之前有短的隋朝三十八年,唐有二百九十年,连隋共三百多年。这是中国第二复兴时期。

    隋代富,是中国历史上最富的朝代。到隋兴起,其潜在的元气慢慢升起而扩大,此乃中国民族内力之恢复,不能以数字来作统计。社会的力量在于优秀的民族性。

    第二十一章 唐代政经状况

    原来自治州和特区是古而有之。

    羁縻府州

    第二十二章 唐玄宗

    安史之乱为唐代由强转弱之转折点,亦可说是中国历史之转折点,此外之明、清诸朝再也无法有开元时期之盛况矣。

    唐之亡并非亡在贵妃身上,实因安禄山之权委实太大,杨贵妃进宫时,天下之大乱早已造成了,故不能责怪贵妃

    第二十三章 唐代衰落

    首先是藩镇割据:节度使掌管人民之财政军事,多在边疆,唐恢复二京后,安史乱将被杀,但其部下降唐并未彻底,仍安排安史旧部担任节度使于原地,即在边疆的军队,后来演变成藩镇。其中最严重的是河北三镇,即成德、卢龙及魏博三镇,均为安史余孽,均是胡人。

    宦官太监为中国特有,此是污点,但也是中国独有的制度。

    唐代政治尚有一弊。中国一有党,就容易出毛病:东汉有党锢之狱,唐代有朋党之乱,宋有新旧党争,明则有东林党。今日英美有政党,多有争吵,也不好。

    第二十四章 唐代异族之乱

    德宗时,回纥已不行了,因他们财产太多,生活腐化,此即民族在都市文明达到最高最盛时往往易于堕落。

    太平天国军之失败在于攻打北京,其毛病在攻城,而不要地方,故失败。

    唐由统一政府而变成五代十国,中有流寇作乱。

    第二十五章 五代十国

    尚有一问题,即五代十国建都,没有一国建都长安的长安是自古以来的天府之国,因当时长安残破。此后的长安,在历史上不占重要地位了,即长安的比重从唐代以后下降了。但此是重要地区,应重新去收拾一番才好。

    总计,五代十国时有四大问题:一是北方黄河流域之衰败。二是长江、珠江流域之像样。三是西北长安之没落。四是东北方即十六州在异族统治下,大敌易于侵入。

    第六篇

    大辽之五京为:(一)上京热河(二)中京热河(三)东京辽阳(四)南京北京(五)西京大同

    第二十七章 宋代

    八国联军时,大沽不准有炮台,北宁铁路是国际线,故无国防线,外国军队可直达北京,北京东交民巷可有英法军,这极不合理,欺人太甚。所以西方之所谓文明文化,上帝、公道、法律、科学……不能使人佩服。

    宋代大人物寇准说,不可逃避,主张御驾亲征,到澶渊渡黄河北,后双方讲和,叫澶渊之盟,自此不再打仗。

    秋收时节,大掠一番,烧屋抢粮,不让农村人口繁荣集中,称“打草谷”。

    太祖奖励读书,但一两天短期内无法造就人才,要到仁宗一百年后才有人才,所谓“十年树木,百年树人”。

    有时历史只能讲时代的局部与形势,有时只能讲人物,人物改造形势,形势限制人物。讲到人物的历史是光明的,讲到形势局面的历史是黑暗的。今天是黑暗的,因今天的世界没有人物。今日的英、美、俄诸国都没有出什么大人物。

    我们不知汉武帝之高矮肥瘦,但可知其脾气、理想、性格……在座之同学不会知道我是如何之人,何况历史上的人物?没有读过王安石和范仲淹的作品,如何会认识他们呢?如何可提出打倒历史呢?真是无聊。

    第二十八章 宋代之文艺复兴

    唐后是门第社会,与贵族封建不同。宋有统一政府,而无世袭贵族。唐之宰相可有世系,一个家族可出十多位宰相。

    南北朝至隋唐有佛教传入,出家是最高第一等人,簪缨是仕宦之家,此非人生真理,但做官不算高,不出家即做居士,皇帝入佛教,封为国师。唐僧即自大门第出家,很伟大。唐僧取经回国,太宗亲迎。社会上和尚称师,社会上之先生,一种是教小孩子,一种是大人在家受学,平民无资格入学,读了书可以做官,做大了官,再跟和尚研究佛法或做居士。

    送儿子出家尚须出大部分家产,故和尚寺很像样。

    今日是耶稣与马克思在争一日之短长,孔子与释迦是差了,因国家没有办法。

    今日之人,“忧者一身,乐者一身”。

    范仲淹开创好的政治风气,负责任,有人格。

    第二十九章 太祖与仁宗

    范之“十事疏”如下:(一)明黜陟(二)抑侥幸(三)精贡举(四)择官长(五)均公田(六)厚农桑(七)修武备(八)减徭役(九)覃恩信(十)重命令

    第三十章 王安石变法

    讲说中国古代制度的有两本书:一本是唐代杜佑的《通典》,一本是宋代马端临的《文献通考》。

    王安石变法之根本毛病是易有流弊,因为这是与民争利。王安石只在法上想,而欧阳修、司马光等人连推行的人也想进去了。总之,政府不应权太大。

    第三十三章 南宋与金之交往

    秦桧以下之南宋,相臣均不济事,国力不振如旧。时女真金国已衰,至成吉思汗伐金,宋亦甚为弱势。金、宋已同趋弱势,已无力抗蒙矣!

    第七篇

    元自成吉思汗至忽必烈灭宋,凡历五世,历时七十四载。

    当时之中国,分宋、金、夏三部,元人用兵,亦先灭金,再平定夏,再取金黄河之南岸,再得长江及南方之地,灭了宋。

    元代世祖最初管治中国之三十多年,几乎每年均用兵,计元世祖十六年灭南宋,此下尚有十五年,而元政府以武力夺取财物,于文治鲜有成绩。且元代帝位之传承并无完美之系统,全靠诸王大臣之拥护,故易生纷争。

    故其来中国,只专注于中国之物阜民富,而不重视文治。统治中国各省之大臣,无一通中国之文墨。治理手法,迥异于中国传统之政制。

    要而言之,元人对汉人、南人持歧视态度,亦不思整顿文治,故亦并非善用汉人、南人,所用悉属坏人,亦不思有好之文治,只求防制反动及征敛赋税两项而已。

    第三十五章 元代税收与经济政策

    元代又行钞法,北宋时,蜀人已有用“交子”,至南宋又用“会子”,金人则推行钞法。元承金制,专行钞法而废钱矣。

    第三十六章 元代军政及军民争地

    最高等级的一种是蒙古军,其次是由蒙古族人担任用来镇守边境的探马赤军,再其次是由中原汉人担任的汉军,最后的一级是由南方宋人担任的新附军。

    第三十七章 元政府赐田及设官政策

    看这本书才知道汉族在元代这么惨,在元朝时蒙古人入侵算是外族入侵罢,但又会与汉人胡人回人的文化产生反应并且融合,现在中国又是56个民族的中国。
    所以当我们谈历史谈传承时,我们在谈什么。自己的民族吗,还是我们在的这片土地。
    每个民族和文化都有应该自己的历史、发展和进化,土地只是民族在历史那个时刻的一个居所。

    汉、回两民族在待遇上有种种的不平等。

    蒙古人之统治有点像古代贵族封建的统治。他们缺少精神生活之陶冶,只有一种宗教的迷信。

    第三十八章 元代之宗教信仰

    在世祖六年之前,蒙古尚是一没有文字的蛮族。到世祖六年时,国师八思巴才创造文字,这之前他们需用文字时,则借用畏兀儿文。

    第三十九章 元代之科举制度

    总之,元代统治中国,历时一百余年,他们对秦汉以来的传统文治政权意识,始终未能接受,其政治意识,始终有封建武装之气味。蒙古人虽曾雄霸欧、亚两洲,却在汉人反抗下,退让出对中国的统治。

    第八篇

    明太祖朱元璋是中国历史上以平民崛起为皇帝的第二人。首位是汉高祖刘邦。

    明代共十六帝,历时二百七十七年,如加入南明三帝,则共有十九帝,达二百九十四年,近三百年矣。

    明代政府对大臣滥用刑杀,其惨酷无理,为有史以来所仅见。

    宋太祖鉴于唐代中期开始武人跋扈,因此积极扶植文官。明太祖则认为自元代没落后,功臣宿将多已诛杀,兵卒多已还乡归田,于是认为社会上唯一可怕的只有读书人。但处理政务一定要用读书人,于是一面推行封建,以扩大王室力量;一面废除宰相,由王室管理国政。但又不能不任用读书人士人,因此用严刑峻法威慑之,使士人在王室的积威下臣服。

    第四十一章 明代之政事

    明代的大臣,如内阁大学士,不易见到皇上。如宪宗成化以后,一直到熹宗天启,前后共一百六十三年,其间只有孝宗弘治在位数年曾经延访过大臣,而世宗、神宗二十余年来并不视朝,大臣也从未见过皇帝。

    明代中叶的帝王多数不见群臣,赵翼的书中也有记述。所以明代中叶,各君王与大学士诸大臣很少相见,相见也不过视朝数刻,君或不识臣,臣或不与君王交一言,君臣之间只是“章奏批答相关接,刑名法度相维持而已”。总之,明代君王昏惰,明代政情安得不乱也。

    制度初创时也许因为有彪悍的身体,初还能实施,但对于组织而言,制度的完善与合理>个人能力,才能维持稳定。

    明代君王昏惰,明代政情安得不乱也。

    第四十二章 明代太监弄权

    即使是为皇上信任权重一时的张居正,当时亦不得不交结太监冯保。

    第四十四章 明代之教育制度

    有现代教育的影子了

    生员如不入学则不得参加科举考试,即是学校与考试两制度融合为一,比唐宋时期更为进步。明末时,此制度已渐废坏,实在十分可惜。

    生员如不入学则不得参加科举考试,即是学校与考试两制度融合为一,比唐宋时期更为进步。明末时,此制度已渐废坏,实在十分可惜。

    都层层选拔了,还是逃不开出生吗…可怜可悲

    凡有出身优异者

    第四十五章 明代之吏治

    故明代之吏治,实超越唐宋之上,几乎有两汉之风也。即使到明代晚年之英宗、武宗时期,仍然民心安定,亦少贪渎之吏使然。

    第四十六章 明代之政制

    由于明代世局平静,武备军事相应松懈了。军政尽归兵部统管,边疆遇有骚扰,调兵拨饷统由兵部主理。

    以上数端,使王室欠缺禄米,卫所缺月粮,边疆缺军饷,各省缺俸银,且冗官日多,募兵日增实减,因此民穷财尽,遂成亡国致命之伤。

    第九篇

    唐代中叶安史之乱以前,中国经济之支撑点偏重于北方的黄河流域。

    丝织业到了明初,从北方移向南方,因此绢税也变成三与一比,即南方多于北方两倍矣。

    至唐代以前,北方输绢给政府日少,南北比例到了八比一的程度,即南方多于北方七倍了

    第四十九章 南方水利农业之发展

    总言之,唐中叶之北方财富,到明时已转到南方,但南方人之生活已较唐代之北方人为苦,亦即显示明代国运不及唐代了。此时财富集中于江南之富豪,小民则水深火热。

    第五十章 宋元明三代之学术

    宋明时期的学者,既非贵族,亦不出世,也不讲功业、礼教。他们讲的是接近平民生活的人生、社会、国家等各方面,而不讲佛老的出世长生之道,亦不讲霸道的君相事业。

    第五十二章 南明之兴亡

    总之,元、明、清三代无藩镇专制之忧,以致平日无准备,而无法禁息乱民之平地突起也。

    封吴三桂为平西王,居云南。封尚可喜为平南王,居广东。封耿精忠为靖南王,居福建。

    第五十三章 清代之政制

    清代十主,共二百六十八年。

    三藩之乱平后,各省钱粮有余者,悉数缴到中央收藏,不准地方存留,因此地方无建设可言。

    雍正以后,更收紧地方银饷,地方更无余款。

    清室对汉人管制甚严,但对蒙古、西藏、青海地区人民,则按旧俗松弛管辖。并不让汉人任职理藩院,以免汉、蒙两族人有交接联络,则自然易于统治管理也。

    第五十四章 清代之军事

    乾隆好大喜功,所耗军费庞大,遂至清代之衰运来临,不可避免。

    第五十五章 明末遗民与清初学风

    首先,北方之士大夫与清政府妥协。但清政府颇用手段,一面照旧制保持汉人习俗,一面严行剃发令,要汉人文化上屈服。

    士大夫之笃实学风与坚贞志气保持数百年之久直至清末。此股力量,使清以武力夺得政权以后,不得不考虑应维护人心之安定。

    康熙由青年时勤学以致咳血而仍不放弃苦读,即使三藩乱起,仍勤读不辍,终于到达无不通晓之境地。而在委曲求全下之中国士人,亦以明末遗民为榜样,因此在参与吏治方面亦甚用心而踏实,遂使清初政况稍胜于明代中叶

    第五十六章 清代之政风与洪杨之乱

    康熙宽仁为怀,到雍正虽治政精明,却刻薄;乾隆则好大喜功,但国富民强。康乾时期相当于唐代贞观与开元、天宝。

    清室之衰落,除帝王日衰外,还加上满官之贪污放肆。如乾隆晚年之和珅为相二十年,贪污达八万万两,相当于国库十年以上之岁入,于是遂有“和珅跌倒,嘉庆吃饱”之谚语。

    地方官吏,已不顾及民生,而只是横加赋敛,刮民脂民膏以利己殃民。此时期户口激增,而民间经济日坏。遂至乾隆末年,民变频频发生。

    洪杨革命最重要之一点,是他们能明白举起种族革命的旗号。

    第五十七章 咸同中兴

    洪杨之失败,并非不能够推翻清政府,而是不能推翻中国社会固有的道德信仰与传统习惯。

    曾、左、李加胡林翼,同为同治中兴之人物,但他们能平乱,却不能办治事。又因清政府猜忌汉人,故不能推诚大用。

    第五十八章 晚清之政局

    道光十八年,政府派林则徐赴广州禁鸦片,终于不敌洋寇,于二十二年订立《南京条约》,割香港给英国,并许五口通商,称为鸦片战争。

    废弃了隋唐以来的科举制,而以学校为替代。于是有“中学为体,西学为用”之理论出现。

    第五十九章 晚清之政治改革

    戊戌政变历时百日,故又称百日政变,或称百日维新。此政变实际上历时九十八天,其失败之原因,在于政变人士依靠皇帝而发动,而皇帝并不可靠。光绪易冲动而机警、严毅不足。当他读到康有为的《波兰亡国记》及《突厥亡国记》时,涕泗横流,富感情而不够严毅沉着。

    出版说明

    钱穆先生乃一代通儒,尤以治史闻名。其与吕思勉、陈垣、陈寅恪并称为“史学四大家”,《国史大纲》风行至今。

  • TCP-Jersey拥塞控制介绍

    介绍

    TCP-Jersey拥塞控制算法在中文世界里的描述非常的少,有点好奇信号和丢包共同控制的算法是怎样的,就翻译了这篇论文,链接在最后。

    传统TCP拥塞控制

    传统TCP的拥塞控制算法是使用拥塞控制窗口来实现的,TCP发送端在发送时除了要兼容接收端的接收窗口,自己这边的发送窗口,还需要考虑拥塞控制窗口。在发送时,取min(w_{r}, w_{s}, w_c),其中w_r是接收窗口,w_s是发送窗口,w_c是拥塞窗口。

    发生丢包事件时,拥塞控制窗口的长度会缩小到一半,然后线性增加逐步增加,即加性增,乘性减(AIMD),这样的设计维护了网络的相对公平和稳定,但是在当今的环境下,移动网络占了互联网流量的很大一部分,移动网络有一个特点就是存在一定的信道丢包,即在发送消息时,本身可能因为信号和干扰的原因,导致发送失败。

    在传统TCP拥塞控制算法里会认为这次丢包是发生了拥塞,进而会缩小拥塞窗口,进而降低TCP的发送速度,但实际情况只是发生了一次丢包,而并没有拥塞。

    TCP-Jersey拥塞控制算法

    这个算法的设计初衷是为了提高无线网络以及无线-有线混合网络通信的传输速度,TCP主要慢的原因是无法区分网络拥塞和无线链接原因的丢包。本协议具有区分这两者的能力,TCP-Jersey包含两个关键部分,可用带宽估计(ABE)算法和拥塞警告(CW)路由配置。

    ABE是一个在发送端持续估计连接的可用带宽,并且在发生拥塞时指导传输速率的算法。

    CW是一个在有迹象发生网络拥塞时,在终端警告的网络路由的配置。CW网络配置对封包进行的标记,可以帮助TCP连接的发送方区分丢包是网络拥塞导致的还是无线链路有问题导致的。

    对比

    在NS-2网络模拟中,当无线网络拥有1%的丢包率,无拥塞的情况下,TCP-Jersey对比TCP-Westwood和TCP-Reno,吞吐量分别提升了17%和85%。

    在发生拥塞,丢包率为1%的无线网络中,TCP-Jersey对比TCP-Westwood和TCP-Reno,吞吐量分别提升了9%和76%。

    TCP-Jersey

    本协议的目标就是将丢包的原因细化,从由拥塞导致的丢包和无线网传输导致的丢包区分开。

    A.可用带宽预估(ABE)

    传统TCP是通过增大窗口,直到发生丢包来判断可用带宽大小。

    TCP-Westwood协议提出了一个有效的办法,在当发送端在t_k时刻收到ACK,记录带宽的采样为:

    b_k=\frac{d_k}{t_k-t_{k-1}}

    其中d_k是ACK确认的数据长度,t_{k-1}是前一个ACK收到的时间。然后再使用Tustin双线性方法近似计算低通滤波,公式如下:

    \hat {b_{k}}=\frac{\frac{2\tau}{t_k-t_{t-1}} - 1}{\frac{2\tau}{t_k+t_{t-1}}+1} \hat b_{k-1}+\frac{b_k+b_{k-1}}{\frac{2\tau}{t_k-t_{k-1}}+1}

    其中\hat b_k表示在t_k时刻的平滑后的预估可用带宽,其中1/\tau是低通频率的截止频率。此外,TCP-Westwood还是用了一个定时器,如果\tau/m(m>2)时间内没有收到ACK则相当于收到了一个b_k = 0的采样。同时受到三个重复的ACK时被TCP-Westwood判定为发生拥塞,将TCP拥塞控制中的ssthreshold设置为:

    ssthresh=\frac{BWE\times RTT_{min}}{seg\_size}

    其中BWE就是预估的带宽,RTT_{min}是TCP预估的最小往返延时,seg\_size是分段大小(segment size,就是MSS中的SS)。如果cwnd>ssthresh并且不在慢启动状态里,拥塞窗口cwnd的被设置为ssthresh,然后并没有明确的指导如何设置\tau和m。

    这里TCP-Jersey采用了相同的估计最大可用带宽的方法:发送方通过观察ACK返回速度,但是采用了一个更加简单的预估。我们提出的方法是基于时间滑动窗口做预估的(TCP-Westwood使用的近似低通滤波器)。

    TCP-Jersey通过监控收到ACK的速度来预估TCP连接的可用带宽,然后是用这个预估来优化拥塞窗口。我们在每个RTT计算一次最佳拥塞窗口,当CW通知需要减小窗口时,TCP-Jersey将cwnd和ssthresh设置为最佳拥塞窗口,ABE的公式如下:

    R_n=\frac{RTT/times R_{n-1}+L_n}{(t_n-t_{n-1})+RTT}

    其中R_n表示在t_n时刻收到第n个ACK之后预估的带宽,t_{n-1}表示前一个ACK到达时间,L_n是第n个ACK确认的数据长度,RTT是TCP估计的往返时间。最佳拥塞控制窗口(ownd)公式如下:

    ownd_n=\frac{RTT\times R_n}{seg\_size}

    其中seg\_size表示分段大小。

    我们的模型有几个优点:

    • 我们对带宽估计的计算很快
    • 不需要配置参数;
    • 同窗口滤波器一样,会随着时间衰减,适合非静态的带宽延迟网络,这是有线-无线混合网络的特性。

    在文中的模拟里,TCP-Jersey的预估带宽对比TCP-Westwood的更加准确。

    B.拥塞警报

    现在的ECN协议会在平均队列长度在min_{th}到max_{th}之间会随机标记封包,路由器不仅会通知发送者发生了拥塞,并且会通过随机标记封包进而影响连接的拥塞控制窗口。

    ECN信息的往返需要时间,而网络情况变化很快,尽管ECN提供了宝贵的信息,但是就在几乎所有的情况下此信息不够及时,使得发送方无法准确快速的应对网络状态变化。而且RED和ECN对参数设置都非常敏感,错误的参数会降低TCP的性能。因此我们提出了一种更简单的通知方案,即拥塞警告(CW),具有更少需要配置的参数,同样能给发送方提供敏感准确的拥塞状况。

    我们建议当平均队列大于某个阈值时,路由器标记所有的封包,并由TCP的发送方来决定如何控制窗口策略。使用IP帧头中的CE位和TCP报头中的ECE和CWR位来传递拥塞信息。这样兼容自1990s时定制的这几个标志位的含义,可以和其他没有CW功能的路由器共同工作。

    后面就不继续翻译了,主要的思路已经描述完了。

    引用

  • Unix编程艺术 读书笔记

    1 哲学

    • 性能—时间的指数曲线对软件开发过程所引发的结果,就是每过18个月,就有一半的知识会过时。Unix并不承诺让你免遭此劫,只是让你的知识投资更趋稳定
    • 策略相对短寿,而机制才会长存
    • 对于程序员和开发人员来说,如果完成某项任务所需要付出的努力对他们是个挑战却又恰好还在力所能及的范围内,他们就会觉得很有乐趣。
    • 那些毫无动力、松松垮垮而且薪水微薄的程序员们,能在短短期限内,如同神灵附体般造出稳定而新颖的软件——这只不过是经理人永远的梦呓罢了。
    • 让每个程序就做好一件事。如果有新任务,就重新开始,不要往原程序中加入新功能而搞得复杂。
    • Unix哲学是这样的:一个程序只做一件事,并做好。程序要能协作。程序要能处理文本流,因为这是最通用的接口。
    • 你无法断定程序会在什么地方耗费运行时间。瓶颈经常出现在想不到的地方,所以别急于胡乱找个地方改代码,除非你已经证实那儿就是瓶颈所在。
    • 估量。在你没对代码进行估量,特别是没找到最耗时的那部分之前,别去优化速度。

      所以实际投入使用的排序算法,都是分层的,在n小时用冒泡,复杂的时候才考虑快排或者并归。

    • 花哨的算法在n 很小时通常很慢,而n通常很小。花哨算法的常数复杂度很大。除非你确定n总是很大,否则不要用花哨算法(即使n很大,也优先考虑原则2)。
    • 其中一种压力就是来自技术上的虚荣心理。
    • 在设计中,你应该主动将代码的复杂度转移到数据之中去。
    • 还不知道瓶颈所在就匆忙进行优化,这可能是唯一一个比乱加功能更损害设计的错误。
    • 先制作原型,再精雕细琢。优化之前先确保能用
    • 如果可能,用C编写前,先用解释性语言搭建原型
    • 看到该做的就去做——短期来看似乎是多做了,但从长期来看,这才是最佳捷径。
    • 一旦某人已经解决了某个问题,就直接拿来利用,不要让骄傲或偏见拽住你又去重做一遍。永远不要蛮干;要多用巧劲,省下力气到需要的时候再用,好钢用在刀刃上。善用工具,尽可能将一切都自动化。
    • 软件设计和实现应该是一门充满快乐的艺术,一种高水平的游戏。

    2 历史——双流记

    现代操作系统虽然很复杂,但确实也就是一个分时系统,在任何时间段让程序独立的运行而已。

    • 如果有足够多眼睛的关注,所有的bug都无处藏身
    • 距开源越近就越繁荣。任何将Unix专有化的企图,只能陷入停滞和衰败。

    3 对比:Unix哲学同其他哲学的比较

    • Unix系统拥有抢先式多任务(preemptive multitasking)能力。在Unix中,时间片由调度程序来分配,这个调度程序定期中断或抢断正在运行的进程而把控制权交给下一个进程。几乎所有的现代操作系统都支持抢占
    • 多用户的概念除了多进程还需要一套权限隔离的系统来维护。
    • 因为Windows没有处理好程序库的版本控制问题,所以长期备受被称为“DLL地狱(DLL hell)”配置问题的折磨,在这个问题中,安装新程序可以任意升级(或降级)现有程序运行依赖的库文件。专用的应用程序库和厂商提供的系统库都存在这个问题:应用程序和特定版本的系统库一起发布非常普遍,一旦没有特定的系统库,应用程序就会无声无息地垮掉。
    • MVS的统一性理念是:一切皆批处理。

    4 模块性:保持清晰,保持简洁

    • 软件设计有两种方式:一种是设计得极为简洁,没有看得到的缺陷;另一种是设计得极为复杂,有缺陷也看不出来。第一种方式的难度要大得多
    • 一些最有能力的开发者,一开始总是定义接口,然后编写简要注释,对其进行描述,最后才编写代码——因为编写注释的过程就阐明了代码必须达到的目的。
    • 假设其它所有因素(如程序员能力)都相同,200 到 400 之间逻辑行的代码是“最佳点”,可能的缺陷密度达到最小。这个大小与所使用的语言无关——这个结论有力支持了本书中其它地方提出的建议
    • 紧凑性就是一个设计是否能装进人脑中的特性。
    • C++是反紧凑性的——该语言的设计者已经承认,他根本不指望有哪个程序员能够完全理解C++。
    • 合理对待紧凑性,设计中尽量考虑,决不随意抛弃。

    5 文本化:好协议产生好实践

    • 当你很想设计一个复杂的二进制文件格式,或一个复杂的二进制应用协议时,通常,明智的做法是躺下来等待这种感觉过去。
    • 使用二进制协议的唯一正当理由是:如果要处理大批量的数据集,因而确实关注能否在介质上获得最大位密度,或是非常关心将数据转化为芯片核心结构所必须的时间或指令开销。
    • 这件事很浅显很正确,却是违反直觉的。设计一个精良的二进制结构存储效率可能不如明文+压缩。

      创建一个简单的工具来做好压缩,要比仅对文件某些部分进行特别压缩更有效,原因在于,压缩工具可以扫描所有数据,然后找到信息中的所有重复部分进行压缩。

    • 创建一个简单的工具来做好压缩,要比仅对文件某些部分进行特别压缩更有效,原因在于,压缩工具可以扫描所有数据,然后找到信息中的所有重复部分进行压缩。
    • 因为网络带宽要比存储昂贵得多,所以需更加重视事务处理的经济性。但如今的宽带费用都很低了。

    6 透明性:来点儿光

    • 透明性和可显性对用户和软件开发人员都很重要。但是重要性体现在不同的方面。用户喜欢 UI 中的这些特性,是因为这意味着学习曲线比较平缓。
    • 这个说法我好喜欢,优雅的代码除了一种自我实现感还有很重要很基础的一点是程序就是面向代码的。

      软件开发者喜欢代码本身(用户不可见部分)的这些品质,因为他们经常需要对代码有很好理解后才能进行修改和调试。

    • 软件开发者喜欢代码本身(用户不可见部分)的这些品质,因为他们经常需要对代码有很好理解后才能进行修改和调试。
    • GCC由一系列处理阶段组成,并由一个驱动程序将其紧密结合在一起。它们是:预处理器、解析器、代码生成器、汇编器和链接器。
    • 要追求代码的透明,最有效的方法很简单,就是不要在具体操作的代码上叠放太多的抽象层。
    • Unix 程序员学到了一种品性,就是宁愿抛弃、重建代码也不愿修补那些蹩脚的代码

    7 多道程序设计:分离进程为独立的功能

    • 总的来说,线程不是降低而是提高了全局复杂度,因此,除非万不得已,尽量避免使用线程。
      -这本书真的好反感使用线程啊,不过想想确实也有合理性。

      通常,你可以发现避免使用线程是可能的。

    8 微型语言:寻找歌唱的乐符

    • 对软件错误模式进行的大量研究得出的一个最一致的结论是,程序员每百行代码出错率和所使用的编程语言在很大程度上无关。[1]更高级的语言可以用更少的行数完成更多的任务,也意味着更少的bug。
    • 美是抵御复杂的最后武器。

    9 生成:提升规格说明的层次

    数据比程序逻辑更易驾驭。

    10 配置:迈出正确的第一步

    -如果有绝对最优解,就不必让用户选择

    首先,对于能够可靠地进行自动检测的东西,就不要提供配置开关。

    • 首先,对于能够可靠地进行自动检测的东西,就不要提供配置开关。

    11 接口:Unix环境下的用户接口设计模式

    • 我们将使用五种度量标准对接口风格进行分类:简洁、表现力、易用、透明和脚本化能力。
    • 当人们说一个用户接口是直观的,他们的意思是(a)它是可显的,(b)用法是透明的,(c)遵循最小立异原则
    • 在Unix传统中,已经形成了良好的接口设计模式,可以完成以上讨论的权衡。
    • 理由三:垃圾信息是对用户带宽的无谓消耗。在屏幕上,这又增加了一个分心的来源,往往让人们不得不在处理更重要的前台工作(例如同他人的交流)的同时耗费心力。

    12 优化

    • 通常,指令加载要比执行花费的时间更多。
    • 例如,在3D图形引擎中,优化旋转操作的sin(x)函数表在现代机器中占据365×4字节的空间。在处理器缓冲速度没有内存查询快时,这显然是个速度优化。但是现在,比起函数表产生的附加缓存击不中的可能开销,每次重新计算可能更快。
    • 实际上,经验法则是尽可能低的时延设计,和忽略带宽成本

    13 复杂度:尽可能简单,但别简单过了头

    • Unix程序员已学到了一种世界观:简单即美即雅即善,而复杂即丑即怪即恶。
      Gabriel 在更关注接口简单性的“MIT”哲学和更重视实现简单性的“New Jersey”哲学之间进行了比较,然后提出,尽管MIT哲学能够引导软件在抽象上做到更好,但New Jersey模型(差者)更具传播特质。
      -原来很多库接口的设计还有这样的考虑

      在MIT哲学中,应该暂停系统调用,伺中断处理完成之后自动恢复之——这较难实现,但接口更为简单;而在New Jersey哲学下,系统调用会返回一个错误表明已被中断,用户必须重新执行——这实现起来非常简单,但编程接口却较难使用。

    • 他所采用的简单实现就是允许“404:Not Found”可以作为一个响应,这使得万维网非常轻便,并获得了广泛的传播和巨大的成功。
    • 重点划一下

      在理想世界,Unix程序员只愿意手工打造小巧完美的软件宝石,每个都那么小巧、那么优雅、那么完美。然而现实中很不幸的是,太多复杂问题需要复杂的解决方案。仅仅十行的程序,再优雅也无法控制喷气客机。

    • 计算资源以及人类的思考,同财富一样,不是靠储藏而是靠消费来证明其价值的
    • 作为vim的信徒必须捍卫,你凭啥这么说!!

      比较而言,vi 看起来相当臃肿而不紧凑。

    14 语言:C还是非C

    • 我语言的极限便是我世界的极限。
    • 这一点确实如此,用C/C++高效但开发维护成本高,但很多时候主要的消耗还是在io和网络

      使用脚本语言的性能损失对真实世界的程序来说经常微不足道,因为真实世界的程序往往受I/O事件等待、网络延迟以及缓存列填充等限制,而非CPU的自身效率。

    • 使用脚本语言的性能损失对真实世界的程序来说经常微不足道,因为真实世界的程序往往受I/O事件等待、网络延迟以及缓存列填充等限制,而非CPU的自身效率。
    • 非常非常认同,因为开发的本质是硬件设备,所有的高级语言虽然屏蔽了硬件体系,但如果要优化还是逃不开的

      即使更高级的语言能够满足编程的要求,我们仍然要学习C,其中一个充分理由就是C能帮助我们学会在硬件体系层次上考虑问题。

    • 即使更高级的语言能够满足编程的要求,我们仍然要学习C,其中一个充分理由就是C能帮助我们学会在硬件体系层次上考虑问题。
    • 总结:C 语言最佳之处是资源效率和接近机器语言。而最糟糕的地方是其编程简直就是资源管理的炼狱。
    • 总结:C++的最佳之处是编译效率以及面向对象和泛型编程的结合。最糟之处是它非常怪异复杂,往往鼓励过分复杂的设计。
    • Java编程语言的设计目标是“write once,run anywhere(一次编写,到处运行)”

    15 工具:开发的战术

    • 作为通用法则,程序90%的执行时间都耗费在10%的代码上。

    19 开放源码:在Unix新社区中编程

    • 多数人在发布自己的项目之前,都是从修补他人的软件而开始接触开源软件开发的。
    • 如果档案文件都是类似GNU风格的名称,主干前缀全小写且只包含字母和数字,后接连字号,后再接版本号、扩展和其它后缀,对大家都有帮助。

    20 未来:危机与机遇

    • Plan 9还有许多其它值得推荐的地方,包括一些问题重重Unix系统调用接口的再造、摒弃了超级用户概念的,以及许多其它有趣的再思考。它的血统没有污点,设计优雅,而且揭露了Unix设计中的一些严重错误。
  • 量化炼金术:中低频量化交易策略研发

    回测

    真实的回测非常重要

    推进分析

    看着很像机器学习的交叉验证,但是实际上不是。

    这个是相当于把分析拆分成多段,类似于用1~ 60跟K线决定第61根k线上操作的一些系数,根据2~ 61根K线决定第62根K线上操作的系数。

    file

    例如按照市值持仓,那每一个周期,就要更新持仓股票占比。

    择时策略

    1. 双均线趋势策略,短线均线>长线均线,看多,否则看空
    2. 双均线反转策略,短线>长线看空,否则看多
    3. 自回归:通过线性回归
    4. 推进分析双线趋势策略
    5. 推进分析双线反转策略
    6. 推进分析混合策略

    择股策略

    1. 市值
    2. 上个月收益反转因子
    3. 推进分析市值

    风险

    风险度量

    在研发量化策略时,由于要使用各种数量化手段来进行模型构建和策略描述,因此选定一个精确的风险度量方式是必须进行的工作。

    对于收益不确定性描述最为清晰的应该是收益率的概率分布,分布情况这种风险度量方式有其优点,但是一般不作为优化函数,而仅仅出现在策略时候的风险分析中。

    方差是一种更简洁但有效的风险度量,可以同时满足风险表征和事后风险描述。

    另外一个指标就是最大回撤。

    最大回撤的计算可以使用自回归计算,把时间如此分批:
    file

    求每个时间段的回撤,然后计算平均值,为该策略的年化最大回撤率。

    最大回撤和年华最大回撤主要是用在事后分析,方差和标准差是可以直接用在策略中的。

    还有

    1. 最大亏损率和年化最大亏损率:从起始点为1开始算的小于1的历史最低点
    2. 半方差和半侧标准差:只计算亏损部分的方差,就是半方差
    3. 目标半方差:将半方差中均值收益率改为目标收益率
    4. 风险价值:给定时间长度范围,设定概率P%,风险价值R使得策略收益小于-R的概率为P%。
    5. 预期损失,预期损失率:跟风险价值差不多。

    风险与收益

    夏普比率= \frac{R - r_f} {\sigma}

    R是交易策略或投资资产的收益率,rf是无风险收益率;σ是交易策略或者投资资产的收益率标准差。这是一个常用的风险调整后收益指标。

    信息比率=\frac{R-r_b}{\sigma (R-r_b)}

    R是交易策略或投资资产的收益率,rb是基准收益率;σ(R-rb)是交易策略或者投资资产的收益率标减去基准收益率后,所得到的新收益序列的标准差。

    索提诺比率=\frac{R-r_f}{\overline \sigma}
    \overline \sigma 是半侧标准差

    除法本身是一个很好的,分子端是收益正面效果,分母端是风险负面效果,符合研判直觉,另外除法保持两者的量纲是一致的,使指标具有较强的逻辑内涵和数学特性。

    止损

    止损是交易行为,在量化交易策略的组成部分中与买卖行为的性质等同。但是脉脉是为了盈利,止损却是为了控制风险。

    止损分为两种,一种是针对单次交易,如果损失大于多少,就强制清仓。

    第二种是针对策略,如果策略损失到了一定程度,则终止该策略的运行。

    作者并不推荐止损的方式,而是认为止损是一个次于仓位决策的风险控制行为。

    仓位决策

    现在的我也意识到,仓位控制是大于择时控制的决策。

    凯利公式

    凯利公式是最著名的仓位决策方法。

    推导太复杂,就当做看懂了吧,整体表达的就是在某个概率读博,已知胜率以及奖励和惩罚的时候,每次应该付出当时多少的本金比例能最小化风险的算法,公式如下:

    f = \frac{pb-q}{b}
    其中胜率是p,押错的概率是b,押中退还押金的b倍,压错就输掉押金
    f是每次赌客的押注比例

    凯利公式有两大核心内涵:

    1. 凯利公式试图规避风险,只要赌局对于赌客而言在概率上有利,赌客就具备将资金增值的潜在能力。凯利公式通过固定比例的押注方式,实现了不会一次性出局的目标,固定比例是该公式的一个核心设置
    2. 凯利公式追寻的目标是,经过多次赌局后,实现赌客资金量的最大化。在推导过程中,最大化往往针对的是收益的期望,这是一个更数学化也更容易处理的做法。

    其他

    还有一种倍赌的押注方法,简单形式就是输了加倍本金,类似于夸张的网格。

    对于凯利公式一定要学会分析,并且把概率用统计算出来对应的参数,然后求导计算。

    实用的仓位决策方法

    仓位决策依赖买卖决策,也依赖于策略对风险的控制。

    无论是实用什么仓位决策,都是在买卖决策已经建立的前提下。

    凯利公式是可能损失100%本金的,我们通过使用风险度量指标,调整仓位设置,使其风险不超过某一个具体水平。

    凯利公式导出的仓位决策更看重收益,风险度量指导出的仓位决策更看重风险。两者侧重不同,是一组比较互补的仓位决策方式。

    一个简单的办法就是仓位f

    f = \min\{f_{凯利}, f_{风险}\}

    结合推进分析,可以让每个交易日进行一次买入卖出的决策,同时变更仓位。

    结合前文的双均线趋势策略,整个决策流程是这样:

    file

    投资组合决策

    上面的部分只考虑择时和仓位控制,没考虑选股。

    马科维茨的最优投资组合理论是业内比较认同的量化交易策略的开端,这一经典模型又被成为均值方差理论,均值方差优化模型、现代投资组合理论等。

    方差和协方差的引入是最优投资组合理论最大的突破所在,通过协方差矩阵来刻画资产间同涨同跌的程度。

    马克维茨的最优投资组合理论

    假设目前有N个风险资产,研究者的目标是基于这N个风险资产,决定投资于各个资产上的具体金额比例,从而最终得到最优的投资组合。

    设N个风险资产的资金占比分别为w1,s2,…wN,各个资金占比均不小于0.研究的目标就是决策出最优的n维向量W,其中

    W=(w_1, w_2,..., w_N)

    由于是投资整体,所以满足:

    \sum_{i=1}^Nw_i=1

    假设构建的投资组合在某一段时间内持有,我们需要知道这段时间内N个风险资产的预期收益率,分别设为r1, r2, …, rN,同时我们也需要知道这段时间内N个风险资产之间的预期协方差矩阵,设为:

    \Sigma = \left( \begin{matrix}
       \sigma_{11} & \sigma_{12} & ... & \sigma_{1N}  \\
       \sigma_{21} & \sigma_{22} & ... & \sigma_{2N}  \\
       ⋮ & ⋮ &  & ⋮  \\
       \sigma_{N1} & \sigma_{N2} & ... & \sigma_{NN}  \\
    \end{matrix} \right)

    其中σij是资产i和资产j之间的预期协方差,σii就是资产i的预期方差。

    基于这些信息,可以计算得到这段时间内整个投资组合的预期收益与预期风险,由于可加性,投资组合的预期收益Rp实际上就是N个风险资产预期收益的线性组合,Vp是投资组合整体的方差,通过选取一个合适的“收益/风险”组合,就可以通过最优化得到最终的资产配比结果,就把配置问题变成了一个优化问题。

    预期收益:
    R_p=\sum_{i=1}^Nw_ir_i
    预期风险:
    V_p=W'\Sigma W
    最优化问题,固定收益的情况下的: \min_W W'\Sigma W
    约束条件:
    \sum_{i=1}^Nw_ir_i=R_M, \sum_{i=1}^Nw_i=1, w_i \ge 0(i=1, 2, ..., N)
    其中R_M是需要提前确定的投资组合收益水平

    这是一个带有多个约束条件的二次最优化问题,提出问题就好,解答就看其他书就行。

    组合投资领域还有另外一种最优化问题,在固定投资组合整体风险的基础上,最大化投资组合的整体收益,数学描述如下:

    优化问题:\max_W\sum_{i=1}^Nw_ir_i
    其中约束条件: W'\Sigma W=V_M, \sum_{i=1}^Nw_i=1, w_i \ge0(i=1, 2, ..., N)
    V_M是需要提前确定的投资组合方差水平。

    还有一种最优化问题是将风险和收益相结合的方式,把他们组合成一个最优化问题,用数学描述如下:

    优化问题:\max_WW'R-\lambda W'\Sigma W
    约束条件: \sum_{i=1}^Nw_i=1, w_i \le0(i=1, 2, ..., N)
    其中R=(r_1, r_2, ..., r_n)',\lambda 是一个用以描述投资者风险偏好的参数,应该为正。

    就把组合投资的问题变成了一个统计和一个假设,统计是能够计算出如何根据做出做优的组合,假设是资产的收益和风险水平不变,这个组合可以推向未来。

    使用的组合优化方法

    如果只依赖数学,可能会产生不切实际的偏差,例如:

    • 某些资产配置为0,另外一些比例会过高
    • 最优配置可能是非常大规模的空头仓位
    • 甚至可能退化成简单的单一性投资

    要解决马科维茨最优投资组合理论的这些缺陷与问题,研究人员提出了很多方法

    带约束的最优投资组合理论

    增加约束条件,例如希望每项都持有一定份额,

    Black-Litterman模型

    这个模型可以人为地增加一些干预来调整数学模型,

    它有一个重要条件是,假设市场上所有大资产所占的份额都是均衡的。

    其过程就是假设所有资产份额均衡的,从而通过逆向马科维茨优化得到均衡情况下不同资产的收益率,这时可以认为调整各个资产的收益率,再正向计算投资占比,整体如下图:

    file

    评价

    收益和风险两个维度

    历史收益率,实操收益率,最大回撤等。

    还包括交易次数这些。

    书的参考文献

    1. 股票作手回忆录
    2. 统计套利
    3. 海龟交易法则
    4. 打开量化投资的黑箱
    5. 主动投资组合管理
    6. 交易策略评估与最佳化
    7. 如何建立自己的算法交易事业

    思考

    1. 这本书写的挺烂的,几乎所有的例子的时间点都是停留在2015年中,同时所有策略的收益在2015年之前又都是基本未盈利的,都是在2015年开始暴涨到2015年年中结束,然后得出结论#$%#$%^#$%。可是2015年谁不知道啊,15年之前买哪只股票不会暴涨呢?年中之后不是一地鸡毛?平时不挣钱,2015年到年中能挣一大波,就能得出结论?所以这本书对于实操部分真的很烂。但是吧,这本书本身给出的两个择时策略就是矛盾的,所以它本身可能也不是想给出具体的策略方法,而是想建立框架,这个角度来说这本书又还不错。给了我挺大的启发,可能是读的第一本量化交易相关的书,关于回测的一些坑位介绍的不错,关于仓位控制也是我之前从未想过的,极大地优化了我自己的交易框架系统,并且给出的双均线策略虽然在市场上无用,但我发现无用是用钱证明的,因此对我来说,这是我第一个执行的策略。
    2. 这是第九章之前对这本书的看法,第九章之后觉得这本书真的还是非常棒的,对于风险和配置的讲解真的让我觉得很厉害,风险把资产仓位问题变成求导的数学过程,还最佳配置变成了一个最优化问题。受益良多。
    3. 别说,最后一章还真不错,把整本书的脉络讲得很清楚,一层一层的如何推进的,如何一点一点把更多的因子加入系统:
      file
    4. 双均线是一个很好地衡量当前价格趋势的指标,可以抓住大涨大跌,但是本身方向性的震荡过于强烈,如果作为主指标来计算,需要更多这个相关的指标来避免方向性反复震荡。但是避免了方向性的震荡必然就会延后上车的概率,感觉对于忽然的爬升和下砸双均线是一个非常好的指标。
  • 量化交易中回测极其重要

    回测

    做了一个高频量化策略,回测数据平均一天翻三倍,昨天用钱测试发现实际一天亏损50%。

    不明白差异为何如此大,在我的直觉里,理论和实际的差距应该非常小,尤其是当用钱测试完了之后,我用同样的策略,在这一段时间里回测结果相差依然很大。

    找了一圈发现原来我在模拟中直接在最新的K线用了真实历史的收盘价,于是我把最新的模拟k线收盘价改成模拟价格,回测收益率立刻和真实收益率相同。

    我用的1分钟k线数据,就这么一个1分钟不到的未来信息,可以让收益从-50%变成300%,真的非常夸张。

    等待和价格尺

    做了量化看着自动交易忽然意识到一件事情就是,投资这件事情最重要的真的就是等待和尺,重要的不是挣多少,而是什么时候买和什么时候卖。

    心里有一把尺,对每个标地有一个未来心理价位的预期,要排除所谓的锚定效应。

    其次就是等待合适的买和卖的时机,并不是说挣2%或者10%就跑,而是说到了预设的某个价格或者涨幅开始回撤就走。

  • Python高性能编程 读书笔记

    主题

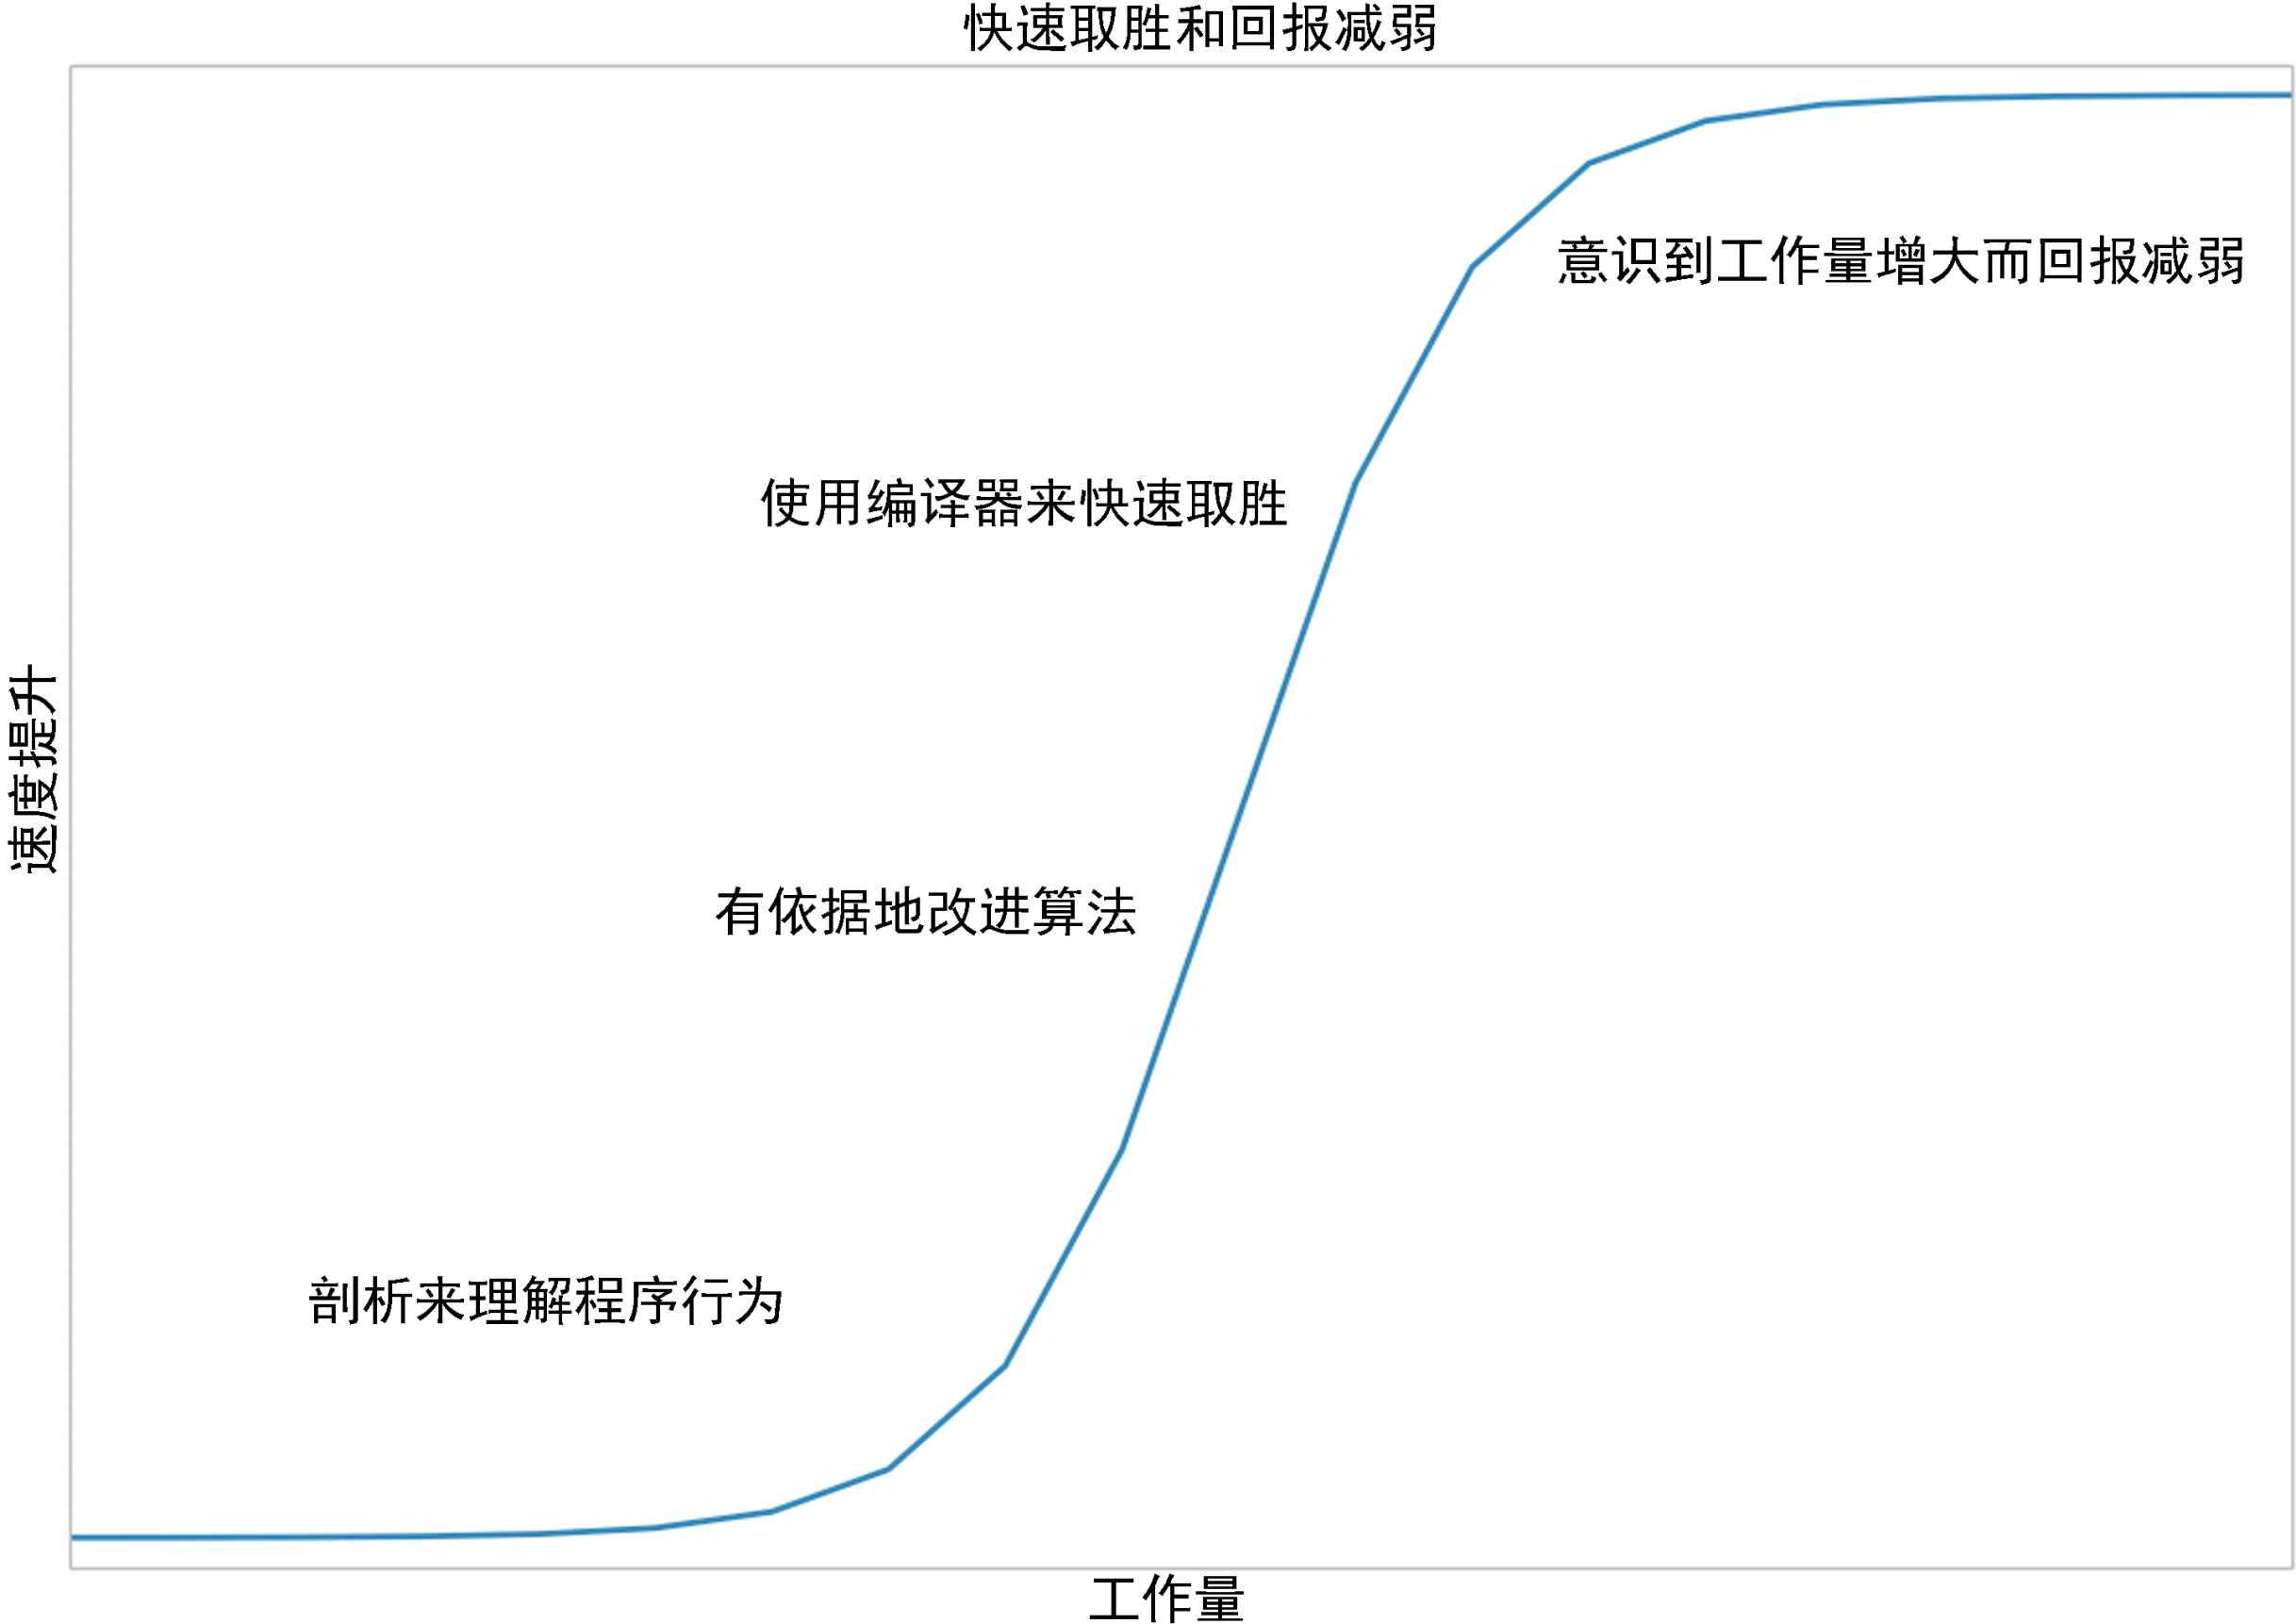
    在当python的函数越短,通常意味着性能越高!

    这不是笑话,在不改变算法的情况下,同一个功能是一定存在一个最短指令集的,当python代码变短意味着指令码变少,那多的指令码就在底层以CPU指令码的形式转移了。

    这叫做同算法指令集数量守恒。 ——本人

    第二章 通过性能分析找到瓶颈

    python可用的分析工具:

    • cProfile:自带的运行分析工具,可以计算函数的执行次数和时间;
    • runsnakerun: 可视化cProfile的内容;
    • link_profile: 分析的更加细致,但是执行效率会变慢,要增加修饰符;
    • memory_profiler:诊断内存的用量
    • heapy:调查堆上的对象
    • dis模块:生成CPython字节码

    heapy模块

    • guppy.hpy() – 获得heapy对象,作为操作接口。
    • heap() – 获得堆中的可见对象(reachable and visible),这些对象并不包含guppy库使用和创建的对象。
    • setref() – 设置一个参考点,下一次调用heap()函数会计算这个参考点之后创建的。
    • heapu() – 获得不可见(循环引用)的对象的状态和列表,heapu()返回一个状态(guppy.heapy.Part.Stat)标明不可见对象。

    dis模块

    获得python的字节码

    def myfunc(alist):
        return len(alist)
    
    >>> dis.dis(myfunc)
      2           0 LOAD_GLOBAL              0 (len)
                  3 LOAD_FAST                0 (alist)
                  6 CALL_FUNCTION            1
                  9 RETURN_VALUE
    
    >>> import math
    >>> def myfunc(x):
    ...     return math.sin(x)
    ...
    >>> import dis
    >>> dis.dis(myfunc)
      2           0 LOAD_GLOBAL              0 (math)
                  2 LOAD_ATTR                1 (sin)
                  4 LOAD_FAST                0 (x)
                  6 CALL_FUNCTION            1
                  8 RETURN_VALUE
    >>> from math import sin
    >>> def myfunc(x):
    ...     return sin(x)
    ...
    >>> dis.dis(myfunc)
      2           0 LOAD_GLOBAL              0 (sin)
                  2 LOAD_FAST                0 (x)
                  4 CALL_FUNCTION            1
                  6 RETURN_VALUE

    默认值不能用可变类型

    >>> def B():
    ...   def A(x=[]):
    ...     x.append(2)
    ...     return x
    ...   return A
    ...
    >>> import dis
    >>> dis.dis(B)
      2           0 BUILD_LIST               0
                  2 BUILD_TUPLE              1
                  4 LOAD_CONST               1 (<code object A at 0x7febe7e5de40, file "<stdin>", line 2>)
                  6 LOAD_CONST               2 ('B.<locals>.A')
                  8 MAKE_FUNCTION            1
                 10 STORE_FAST               0 (A)
    
      5          12 LOAD_FAST                0 (A)
                 14 RETURN_VALUE
    
    
    构建了一个函数,是B.<locals>.A,并且list作为默认值一开始就存进去了
    >>> def X(x=[]):
    ...   return x
    ...
    >>> X.__defaults__
    ([],)

    第三章 列表和元祖

    python使用魔法函数eq和lt来进行对象的比较。

    bisect模块是二分查找模块

    通用代码会比某个特定问题设计的代码慢很多。

    blist是比默认的list在存在大量修改的list场景下实现更快的数据结构。

    第四章 字典和集合

    python在va == vb的判断内部调用的是eq方法。

    可以被散列(哈希)的对象是同时实现了hash的魔法函数以及eq或者cmp两者之一的类型。

    这里一定要实现eq或者cmp为了防止两个对象的hash相同,那样就需要判断两个对象是否相等,如果相等则是同一个,不然则是不同的。

    python对dict本质就是一个hash表,底层对hash冲突的处理方式是开放寻址法

    同时在python的dict到达容量的2/3时会发生扩容,扩容的复杂度是O(n)的,需要将所有的对象都重新hash一次。

    每当python访问一个变量、函数或模块时,首先会查找locals()数组,其内保存了所有本地变量的条目,如果不在本地变量里那么搜索globals()字典,最后如果对象也不在则搜索builtin对象。这里可能为了搜一个函数或者变量要搜好几个dict。

    第五章 迭代器和生成器

    代码每次运行到yield该函数就会“发射”出一个值,然后外部代码需求另一个值时该函数才会继续运行(上下文会保存)。

    使用python的内置函数iter来创建迭代器,iter函数会返回对象的iter属性:

    # python的循环
    for i in object:
        do_work(i)
    
    # 等价于
    object_iterator = iter(object)
    while 1:
        try:
            i = object_iterator.next()
            do_work(i)
        except StopIteration:
            break

    如果只是计算满足某个条件的列表数量,这样可以节省一笔内存

    # 不要写:
    [i for i in xrange(n) if i % 3 == 0]
    # 要用:
    sum((1 for i in xrange(n) if i % 3 == 0))
    
    ----------------------
    项目里一些代码的鞭尸:
    level_aver = float(sum([member.rank_level for member in self.member_dict.values()])) / self.size
    
    total_num = sum([abs(value) for value in pop_result.itervalues()])
    
    sum([mgr.busy_count for mgr in self.combat_mgr.itervalues()])
    
    # 这里每次+可能会增加一次内存分配和复制
    # 用list(chain()) 在1000*1000的对象上操作要快396倍
    task_list = reduce(lambda x, y: x + y, task_level_list)
    
    # 而且原场景其实不需要这个list,拼接了之后只是一次性使用直接返回迭代器即可

    python里一些表达式:

    • 列表表达式: [f(xx) for xx in rr if xx else f(xx)]
    • 生成器表达式: (f(xx) for xx in rr if xx else f(xx))
    • 字典表达式: { key_expr: value_expr for value in collection if condition }
    • 集合生成器: {f(xx) for xx in rr if xx else f(xx)}

    在这里记录一下。

    标准库中的itertools库提供了内建函数map, reduce, filter和zip的生成器版本(分别是imap, ireduce, ifilter和izip),以及其他很多有用的函数,特别是:

    • islice 允许对一个无穷生成器进行切片
    • chain 讲多个生成器链接到一起
    • takewhile 给生成器添加一个终止条件
    • cycle 通过不断重复将一个有限生成器变成无穷

    顺便记录一下上面几个函数的功能:

    • map(function, iterable, …): 将参数以函数执行的生成器
    • reduce(function, iterable[, initializer]): 跟map类似,不过f的参数是两个,先对迭代器中的第 1、2 个元素进行操作,得到的结果再与第三个数据用 function 函数运算,最后得到一个结果。
    • filter(function, iterable): 对迭代器的对象执行f来进行过滤,为True才会返回
    • zip([iterable, …]): 将对象中对应的元素打包成一个个元组,然后返回由这些元组组成的列表。
    • any(iterable), 如果 iterable 的任一元素为真值则返回 True。
    • all(iterable), 如果 iterable 的所有元素都为真值则返回 True。

    第六章 矩阵和矢量计算

    原生python并不支持矢量操作,主要的核心原因是python的列结构存储的内容是指向对象的指针,其次python的字节码没有对矢量操作做优化。

    result = 0
    for i xrange(num_iterations):
       result += i * sin(num_iterations)
    return result
    
    # 下面这个快过上面那个,虽然是废话,但是很实用
    result = 0
    for i xrange(num_iterations):
       result += i
    return result * sin(num_iterations)
    
    # -------------------------------------
    # damage_system
    for ratio in reduce_ratio_list:
        damage *= ratio
    
    # 比上面要快16%
    damage = reduce(operator.mul, reduce_ratio_list, damage)
    
    # -------------------------------------

    书中用numpy去优化一段代码,带来了40倍的效率提升,但是神奇的事情是,禁用矢量指令集优化,性能依然有极大的提高,用perf分析发现矢量操作近带来了40倍中的15%,剩下的是内存问题导致的效率低下。

    perf是一个进程级别的分析工具。

    numexpr

    将python能够分析执行顺序,非常大程度的优化矩阵,可以自动地利用多CPU的优势,并且考虑到CPU缓存的问题,会特意移动数据让各级CPU缓存拥有正确的数据。

    如果numpy可以将速度快几倍,那使用numexpr可能可以将速度提升至几十上百倍。

    但是如果矩阵特别小,会有负优化的效果。

    第七章 编译成C

    Cython、Shed Skin和Pythran是纯粹的基于C的编译方式,凭借Numba的基于LLVM的编译方式,还有替代虚拟机的pypy,内置了一个即时编译器(JIT)。

    无论使用哪条路线,都要在适用性和团队效率上作出权衡,

    image

    优化是永无止尽的,但是对一个模块的优化是有限的。

    顺便一提,pyc只是py编译成的python机器码,并不包含优化。

    对python的优化

    Cython

    可以直接把python代码编译成so,可以先用Cython在服务端优化一轮,顺便提前把模块化做好。

    Shed Skin

    将python翻译成C++的编译器,会自动去猜测类型,可以直接被import,不像Cython需要显式指定类型。

    Shed Skin会将python的list拷贝成Shed Skin环境的变量,这个是会花时间的,

    numba

    llvm编译器的python脚本编译,只需要在需要编译的函数增加@jit()修饰符即可,执行速度非常快

    Pythran

    有点像Numba和Cython——我注解函数的参数,接着它接管进一步的类型注解和代码特化,它会利用OpenMP的并行化可能性。

    pypy

    底层换了虚拟机,提供了JIT,执行时编译,所以第一次会很慢,编译好之后再执行非常快!

    pypy和CPython的垃圾回收机制不同。

    任何纯python的库pypy都能直接安装运行,但是有C扩展库的就可能无法工作。

    内存消耗比cpython多。

    写C/C++程序的优化

    ctypes

    C++只写一些函数,然后通过ctypes来”import”进python,需要在python层将所有的调用对象都转化成ctypes对应的C类型,然后执行。

    这里在使用list或者dict的时候,会非常非常消耗。

    cffi

    相比ctypes方便很多,并且支持一些很便利的语法糖。

    CPython模块

    我们项目里目前是用的模块,会很繁琐,很简单的代码也要写几十行来兼容,但是好处是控制颗粒度非常高,从无视GIL到引用计数,一切都可以直接去修改,但是对程序的要求也会高一点,因为需要了解python的一些细节。

    在大部分情况下,书中的建议是不使用这种方式。

    第八章 并发

    时间循环有两种方式:回调或者future。

    回调会带来很长的调用链,future+asyncio是一个很好的,不过我们用python2是永远没机会用了。

    分别使用了gevent,tomado和asyncio

    第九章 multiprocessing模块

    可以让程序基于进程和线程的并行处理,multiprocessing.Pool的功能感觉很强!

    对于使用这个模块,需要解决的问题:

    • 把工作拆分成独立的工作单元
    • 考虑是否能随机化工作序列
    • 尽量让同时在处理的任务数量和CPU数量相同

    第十章 集群和工作队列

    一个容易调适的系统可能胜过一个更快的系统。

    • 启动组件:cron任务,Circus或supervisord
    • 测试容灾的组件:ChaosMonkey
    • 部署系统:Fabric、Salt、Chef或Puppet

    下面几个都是集群化的方案

    Parallel Python模块

    • 几乎没有依赖性,接口简单;
    • 不是很强大,缺少通信机制

    Ipython Parallel

    IPython作为shell做并行任务控制,依赖ZeroMQ。

    NSQ

    是一个可随时投入生产的队列系统,有持久性和扩展性。

    其他集群化的工具

    • Celery
    • Gearman
    • PyRes
    • 亚马逊的简单队列服务(SQS)

    第十一章 使用更少的RAM

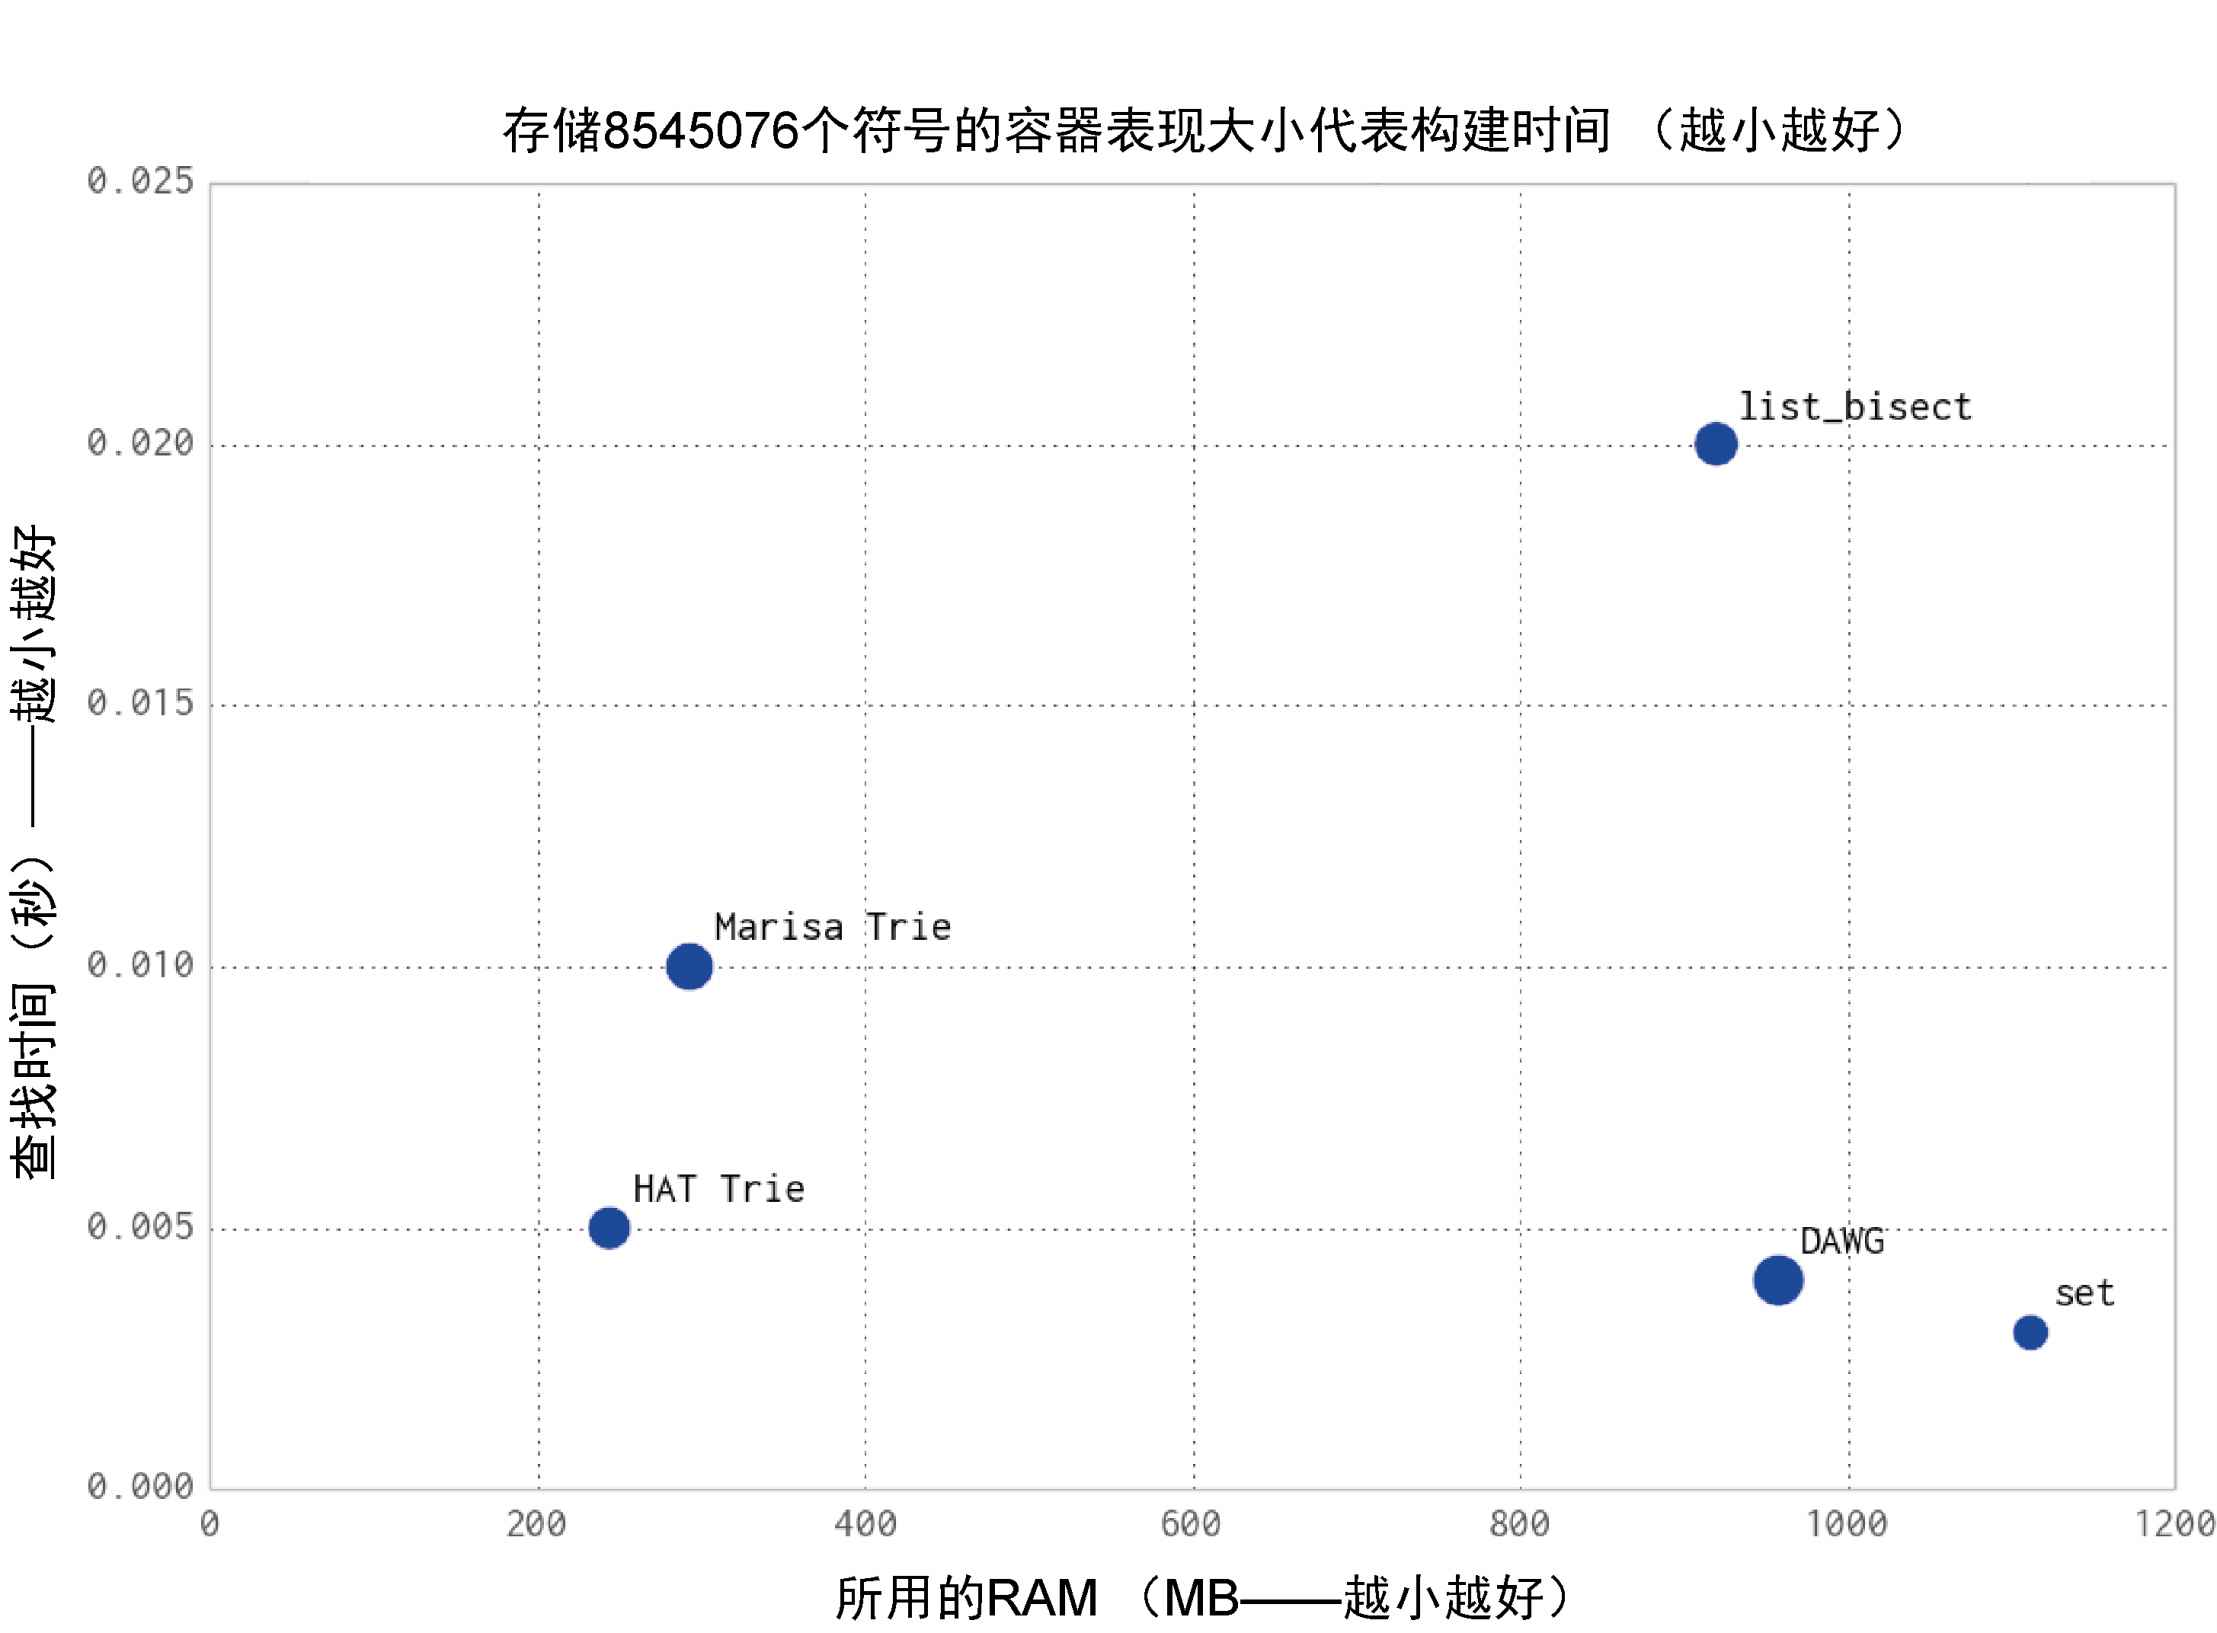
    基础对象开销高:100000000项的list要消耗760MB的内存,可以替换成array,array是连续的内存块,而且array可以直接传递给C++层不需要额外的转换。

    python3对字符串的存储效率相比python2提高了很多。

    image

    高效地存储文本,trie树和有向无环图 (DAWG)(双trie树结构)单词图:

    通过允许概率误差来减少数据集需要的内存空间:

    • Morris计数器
    • 布隆过滤器
    • loglog计数器

    End.