博客

  • [Asio] 学习笔记1. 初识asio和tcp

    打算基于asio写多种序列化库的测评,在底层用同一个asio构造函数的方式,然后上层测试脚本里切换序列化的实现。
    但是最开始按着demo写逻辑就出现了问题,我想先纯面向过程,就没像demo里写一个connection类,然后就探究到一直会闪退的问题。

    最后定位到时ip::tcp::socket析构的时候会断开连接。

    socket的析构会断开连接

    socket的大概是这样的结构:

    typedef basic_stream_socket<tcp> socket;
    template <typename Protocol, typename Executor>
    class basic_stream_socket
      : public basic_socket<Protocol, Executor>;
    {};
    
    template <typename Protocol, typename Executor>
    class basic_socket: public socket_base
    {
    // ....
      ~basic_socket()
      {
      }
    
    #if defined(BOOST_ASIO_WINDOWS_RUNTIME)
      detail::io_object_impl<
        detail::null_socket_service<Protocol>, Executor> impl_;
    #elif defined(BOOST_ASIO_HAS_IOCP)
      detail::io_object_impl<
        detail::win_iocp_socket_service<Protocol>, Executor> impl_;
    #elif defined(BOOST_ASIO_HAS_IO_URING_AS_DEFAULT)
      detail::io_object_impl<
        detail::io_uring_socket_service<Protocol>, Executor> impl_;
    #else
      detail::io_object_impl<
        detail::reactive_socket_service<Protocol>, Executor> impl_;
    #endif
    };

    大概是这样的关系,虽然basic_socket, basic_stream_socket和tcp都没有在析构函数里做逻辑。但是实际实现操作系统连接句柄的impl_的析构函数里有做逻辑的,而且实现的方式还挺巧妙。
    Windows的io_uring_socket_service和Linux的reactive_socket_service都没有在析构里做逻辑,这一部分是在detail::io_object_impl里做的。

    template <typename IoObjectService,
        typename Executor = io_context::executor_type>
    class io_object_impl
    {
    public:
      typedef IoObjectService service_type;
      // Construct an I/O object using an executor.
      explicit io_object_impl(int, const executor_type& ex)
        : service_(&boost::asio::use_service<IoObjectService>(
              io_object_impl::get_context(ex))),
          executor_(ex)
      {
        service_->construct(implementation_);
      }
    
      // Destructor.
      ~io_object_impl()
      {
        service_->destroy(implementation_);
      }
    
    private:
      // The service associated with the I/O object.
      service_type* service_;
    };

    也就是io_object_impl本身实现的是IoObjectService的生命周期管理,对操作系统的io对象进行统一的封装,给上层提供统一的接口。然后通过模板类可以切换实际实现的方式。

    同时如小标题所示,ip::tcp::socket这类对象在析构的时候会断开连接,所以在asio实际使用过程中,一定要抓住socket的生命周期。

    ip::tcp::socket

    顺便深入看一下tcp的连接实现细节,我们以Linux的视角看一下实现细节。

    socket_base

    我们从最底层看起,basic_socket继承自socket_base,socket_base是一个定义了全双工半双工状态,当前等待状态的抽象类。它的抽象体现在析构函数实现在protetecd里,只有子类对象可以被析构。

    class socket_base
    {
    public:
      /// Different ways a socket may be shutdown.
      enum shutdown_type
      {
    #if defined(GENERATING_DOCUMENTATION)
        /// Shutdown the receive side of the socket.
        shutdown_receive = implementation_defined,
    
        /// Shutdown the send side of the socket.
        shutdown_send = implementation_defined,
    
        /// Shutdown both send and receive on the socket.
        shutdown_both = implementation_defined
    #else
        shutdown_receive = BOOST_ASIO_OS_DEF(SHUT_RD),
        shutdown_send = BOOST_ASIO_OS_DEF(SHUT_WR),
        shutdown_both = BOOST_ASIO_OS_DEF(SHUT_RDWR)
    #endif
      };
      // ....
    protected:
      /// Protected destructor to prevent deletion through this type.
      ~socket_base()
      {
      }
    };

    basic_socket

    template <typename Protocol, typename Executor>
    class basic_socket
      : public socket_base
    {
      detail::io_object_impl<
        detail::reactive_socket_service<Protocol>, Executor> impl_;
    };

    这个对象是对套接字做的一个高级抽象,类似于Linux里万物都是socket,可以read and write,具体的上层协议本身是定义在Protocol里面,Protocol包含协议本身以及endpoint,也就是地址。

    例如TCP的endpoint就是IP和地址,感觉如果未来KCP或者其他协议,可以直接定义一个新的endpoint类,增加多个channel就能实现很多东西,没必要用多个实际上的操作系统套接口?
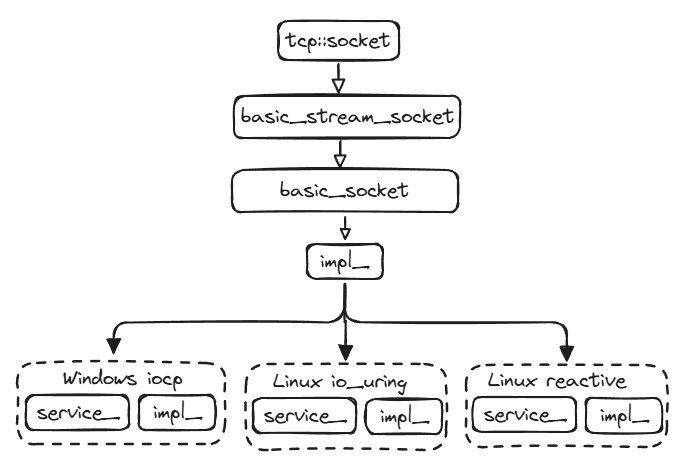
    这些实际操作系统的实现又落地在impl_里,impl_实际上是一个io_object,不同的系统会是不同的实现,但是保持统一的对外接口,大概如下图:
    file

    我们从最底下向上看,在每个操作系统底层其实有两个部分,service_和implement_,他们互为一组向上和向下的关系抽象,implement_是service_类里的一个struct,主要包含该操作系统API下的资源细节,通常包含套接口句柄,上层协议类型,以及其他的一些数据。
    例如在Linux下,所有的socket都是用int类型的一个句柄,无论是Tcp还是文件还是Udp协议都是同一个句柄。所以implement_里存了套接口以及具体的Tcp还是Udp协议。
    service_则是对操作系统的API提供的一层service抽象,将不同的操作系统的IO接口提供成统一的API,这里实现了创建、连接、收发消息和关闭连接。
    而整个service_会被basic_socket用作操作系统无关的io对象的实现,而基于这些,basic_socket向上层提供了连接和异步的基本能力,创建、管理、异步等待等…
    再进一步basic_stream_socket则是向上层提供了进一步的读写能力。

    本次就先读到这里吧。

    End.

  • [Walo系列]2.企划和环境搭建

    企划

    还是打算启动这个企划,核心的目标就像前一篇说的,我想做一个游戏的网络rpc的库。相比传统的rpc框架,核心在于这个是给游戏用的。

    思考

    游戏用的rpc和互联网的主要差别在哪呢?
    这几天我一直在思考这个问题,互联网的请求更多的是我发起、等待然后收到回调。同时互联网有大量的基础设施,在rpc的通信中有大量的扩散的请求。例如一个订单可能涉及到向多个微服务发起服务,最终汇聚成一个请求返回到客户端。

    互联网的rpc更注重跨语言,快速实现需求,还要考虑多服务的均衡、容灾等等…

    而游戏的网络框架其实分两个部分,拿平安京举例,大厅的部分跟互联网的rpc没有太多差别的;但是战斗跟大部分互联网的需求是不同的,战斗更注重的是快速地相应,对游戏战场的控制方式。

    所以我做这个还是有意义的,例如互联网的rpc框架默认就是基于TCP的,附带大量微服务特性的。

    期望的特性

    1. 基于C++20:目的是学习;
    2. 支持UDP、TCP和WebSocket等协议:目的适配更广泛的游戏场景;
    3. 提供网卡、网络到连接层面的封装:目的是对网络有更精确的掌控力;
    4. 提供基于Entity和属性的同步:简化游戏开发;
    5. 提供局域网探测的功能:同样是为了提供简化的联网能力;

    环境和依赖

    稍微研究了一下,最后还是决定使用CMake + Conan做依赖管理。
    尽量用公版以及conan中拥有的库做开发,减少我的开发成本,以及未来可能的管理成本。

    倒腾了一个晚上,终于把conan2和cmake的融合做好了。
    由CMake构建的时候引入conan2的conan_provider.cmake,这个cmake提供自动从云端的conan find_package,解决依赖问题。
    工程只需要包含CMake以及工程源码,CMake就能自动从公版拉相应的库下来。

    以及工程命名:Walo,想着朗朗上口,又要含义简单,取自网络的中文谐音。

    End。

  • [Walo系列]1.开发自己的游戏通讯库对grpc祛魅了

    本意是想深入研究和学习一下grpc的设计,来给自己的游戏网络通信引擎提供多一份参考。但是细致的看了一圈文档意识到grpc的实际应用场景不是给游戏,而是像文档里描述的给微服务和多语言部署的大型业务。

    grpc作为定义好comn中间结构体就能够注册到服务发现集群,其他的业务可以直接将comn结构下载下来,快速地请求到新业务的一套跨越多语言的协议+底层框架。

    这是它的核心,或者说它解决的问题。

    就忽然想起来之前华仔说面试的是时候是要问对方解决问题的能力,遇到了什么问题,提出了什么方案。

    最近也研究godot和unreal的网络框架实现原理,顺便也看了一下如何给这些引擎做共享。

    就看见godot的贡献原则:

    file

    file

    file

    要从问题出发寻找结论,而不是我觉得这个可以,然后它就可以。要解决一个具体的问题,解决常见的问题。

    不想当厨子的裁缝绝不是好司机,我今年想自己写一个网络通信引擎,一方面是学习和练习,另外也想对工作有一些反哺。最近就也在思考,如果真的开始动手写我的库,这个库需要哪些特性?如何跟其他的引擎结合?甚至如何让其他人用我的这个库?

    特性:

    1. 基于C++20,目的是学习和练习C++20;
    2. 支持UDP、TCP和WebSocket等协议;
    3. 提供网卡、网络到连接层面的封装;
    4. 提供基于Entity和属性同步和管理和rpc;
    5. 提供局域网探测的功能;

    如何跟引擎和语言结合:

    1. python: nanobind
    2. lua: 未来可以支持
    3. UE:不好融合;
    4. Unity: 增加插件
    5. Godot:

    如何让其他人用:

    1. 开源
    2. 好用

    End。

  • 用python理解C++20协程的设计

    C++20拥有一个全新的特性:协程。

    我来从python的角度来解释C++这个特性设计与其他语言的不同,目的以及意义。

    协程是一种可以挂起和恢复执行的函数。C++20协程跟python的生成器是很相似的,如果函数中出现了co_yield, co_return, co_await,那么这个函数就是协程函数。而协程的本质就是将一个函数拆分成多个不能控制执行顺序,但是可以控制执行时机的语言结构。

    对普通函数而言,执行一个函数是开始运行你的逻辑;但是对于协程来说,执行协程函数会先创建一个协程对象,但是是否开始执行还是挂起是视情况而定的。

    例如这个python代码:

    def hello():
        print("Start run")
        ret = yield2
        print("After suspend", ret)
        yield3
        print("After Suspend")
    
    def main():
        generator=hello()
        print(generator)
        ret1 = next(generator)
        print("ret1: ", ret1)
        ret2 = generator.send(23)
        print("ret2: ", ret2)
        generator.send(23)

    在这里hello就是一个协程函数,执行之后会获得一个generator,对generator执行send或者next才会开始真正的执行协程逻辑,从头或者从上次执行的地方一直直行到下一个yield,然后再挂起返回给外面。

    python的生成器跟C++协程很像,都是无栈协程,但是C++的更复杂,因为C++是需要自定义协程对象。
    例如这个简单的C++逻辑:

    TaskCoroutine task_func() {
        std::cout << "task first run" << std::endl;
        co_yield 6;
        std::cout << "---before await task2---" << std::endl;
        co_await task2();
        std::cout << "task resume" << std::endl;
        co_return 3;
    }
    
    int main() {
        std::cout << "Before task_func" << std::endl; 
        TaskCoroutine load_task = task_func();
        std::cout << "After task_func" << std::endl;
        load_task.resume();
        std::cout << "After resume" << std::endl;
        return 0;
    }

    这里因为有co_yield,所以task_func是一个协程函数,但是跟python不同,C++需要定义携程的返回类型,是一个自定义类型,代表的这个携程的Task或者Coroutine。

    这个类型类型必须包含promise_type名字的PromiseType类,例如:

    struct TaskCoroutine
    {
        using promise_type = PromiseType;
    }

    没有这个那编译就会异常,感觉这个是类似于C++20的概念约束做的。

    promise_type又是另外一个约束的类,必须拥有几个必须定义的函数,以及几个可选定义的函数:

    struct PromiseType {
        PromiseType()
        {
            std::cout << "PromiseType" << std::endl;
        }
        TaskCoroutine get_return_object() {
            std::cout << "get_return_object" << std::endl;
            return TaskCoroutine{std::coroutine_handle<PromiseType>::from_promise(*this)};
        }
        std::suspend_never initial_suspend() noexcept {
            std::cout << "initial_suspend" << std::endl;
            return {};
        }
        Awaiter<true> final_suspend() noexcept {
            std::cout << "final_suspend" << std::endl;
            return {};
        }
        void unhandled_exception() {
            std::cout << "unhandled_exception" << std::endl;
        }
        std::suspend_always yield_value(int x) noexcept {
            std::cout << "yield_value" << std::endl;
            return {};
        }
        void return_value(int x) noexcept {
            std::cout << "return_value" << std::endl;
        }
    };

    剩下的内容实在是不想写了,看我的视频吧:
    https://www.bilibili.com/video/BV1H66aYTE84

  • constexpr, consteval, constinit家族

    介绍

    这是《现代C++语言核心特性解析》的读书笔记。

    constexpr家族的内容

    书里给constexpr给了很多篇幅,但是总体来说就是一个,const表示的是不允许修改的常量,而constexpr表示的是编译期的常量。
    但是逐渐被扩展到constexpr可以被用作函数,lambda,以及if constexprt,都是为了让编译期可以做更多的事情,给与开发者更多的自主性。
    反正基本上想要去做一些预计算以及在模板里,用constexpr就没错了。

    consteval是什么呢?

    这件事情我理解来说就是constexpr被扩展定义之后的一个收缩,constexpr最初是为了定义编译期的常量,好让编译器在编译器做一些逻辑。但是逐渐扩展到函数也能放,同时运行期也能调用constexpr的函数。
    那consteval做的事情就是,定义一个函数,这个函数只允许编译期运行。

    说实话,有点过渡定义……

    constinit的构造

    因为之前做一个东西遇到过类似的依赖问题,后来用了宏+一个很取巧的类构造的方式来保证顺序。
    然后C++20提供了一个更简单的方法,constinit保证在编译期就会初始化对象,相当于是最早初始化的一批对象。

    1. 编译期的计算都可以在编译期算好,就不会有启动的依赖关系;
    2. 可以被其他的非constinit对象依赖。

    is_constant_evaluated

    新标准还提供了一个新函数,用于区分当前逻辑运行在编译期还是运行时,可以用if constexpr去做不同的逻辑。

    #include <cmath>
    #include <type_traits>
    constexpr double power(double b, int x) {
      if (std::is_constant_evaluated() && x >= 0) {
        double r = 1.0, p = b;
        unsigned u = (unsigned)x;
        while (u != 0) {
          if (u & 1) r *= p;
          u /= 2;
          p *= p;
        }
        return r;
      } else {
        return std::pow(b, (double)x);
      }
    }
    
    int main() 
    {
      constexpr double kilo = power(10.0, 3);  // 常量求值
      int n = 3;
      double mucho = power(10.0, n);           // 非常量求值
      return 0;
    }
  • [2024年10月31日]

    今天生命状态异常的好!很难描述是怎么造成的,在公司忙了一些事情,吃完饭之后就开始玩游戏,玩了几把就回家…
    路上听着睡眠那本书,哦,那句话我印象很深:然而值得注意的是,无论机会有多大,大脑都无法恢复它失去的所有睡眠。人类永远不能把我们之前失去的睡眠补回来。
    可能是这句话打醒了我,让我今天生命状态异常的好!
    回家就先吃药,收拾东西,久违的拖地,处理各种垃圾…

    今天精神上的状态真的还挺舒服的,可能是被睡眠的警告惊醒,也可能是之前生病的后遗症。
    总之,希望明天能保持这个状态,每天10点开始集中注意力有点太迟了,因为很快就到中午困倦的时间了,要再早起一点。

  • 结构化绑定(C++17, C++20) 学习笔记

    结构化绑定

    在python中是能够很轻易地实现多个返回值的函数的,例如:

    def return_multi_values():
      return 100, 20
    x, y = return_multi_values()

    但是在C++应该是会用类、结构体或者引用来实现,在C++11之后也引入了std::tuple,也可以用来实现类似的功能:

    #include <iostream>
    #include <tuple>
    
    std::tuple<int, int> return_multiple_values()
    {
      return std::make_tuple(11, 7);
    }
    
    int main()
    {
      int x = 0, y = 0;
      std::tie(x, y) = return_multiple_values();
      std::cout << "x=" << x << " y=" << y << std::endl;
    }

    这里定义和获取都很麻烦:

    1. 定义的时候需要显示指定返回类型;
    2. 同时在用std::tie解邦定前需要先声明x, y的变量。
      第一个问题可以通过auto来实现:

      auto return_multiple_values()
      {
      return std::make_tuple(11, 7);
      }

      第二个问题就需要使用C++17引入的新特性——结构化绑定。

    所谓结构化绑定是指将一个或多个名称绑定到初始化对象中的一个或多个子对象(或者元素)上,相当于给初始化对象的子对象起了别名。这里引用和别名是有区别的。
    使用结构化绑定的方式是 auto[xx, yy, zz] = xxxx,例如:

    #include <iostream>
    #include <tuple>
    
    auto return_multiple_values()
    {
      return std::make_tuple(11, 7);
    }
    
    int main()
    {
      auto[x, y] = return_multiple_values();
      std::cout << "x=" << x << " y=" << y << std::endl;
    }

    但右边的值也不一定非得是函数返回值或者tuple,合理的表达式也行:

    #include <iostream>
    #include <string>
    
    struct BindTest {
      int a = 42;
      std::string b = "hello structured binding";
    };
    
    int main()
    {
      BindTest bt;
      auto[x, y] = bt;
      std::cout << "x=" << x << " y=" << y << std::endl;
    }

    在for循环里会有更好的效果:

    #include <iostream>
    #include <string>
    #include <vector>
    
    struct BindTest {
      int a = 42;
      std::string b = "hello structured binding";
    };
    
    int main()
    {
      std::vector<BindTest> bt{ {11, "hello"},  {7, "c++"},  {42, "world"} };
      for (const auto& [x, y] : bt) {
           std::cout << "x=" << x << " y=" << y << std::endl;
      }
    }

    深入理解

    这两个理解是错误的:

    1. 结构化绑定的目标就是等号右边的对象
    2. 所谓的别名就是对等号右边对象的子对象或者元素的引用。

    在结构化绑定中编译器会根据限定符生成一个等号右边对象的匿名副本,而绑定的对象正是这个副本而非原对象本身。
    auto [xx, yy, zz]是能够增加修饰符的,例如const,volatile等, 甚至&引用也可以,这些都会直接作用在新的变量上。

    结构化绑定3种类型

    包括原生数组、结构体和类对象、元组和类元组的对象。

    绑定原生数组

    它是所有情况中最简单的,条件是别名数量和数组数量一致。

    绑定到结构体和类对象

    首先,类或者结构体中的非静态数据成员个数必须和标识符列表中的别名的个数相同;其次,这些数据成员必须是公有的(C++20标准修改了此项规则,详情见20.5节);这些数据成员必须是在同一个类或者基类中;最后,绑定的类和结构体中不能存在匿名联合体

    绑定到元祖和类元祖对象

    类元祖对象的定义比较复杂,不像python有ABC这种元类,C++是通过模板实现判断,目标类型提供std::tuple_size、std::tuple_element以及get的特化或者偏特化版本即算是类元祖对象。

    在标准库中,除了std::tuple,还有std::pair和std::array也满足这个条件,这就带来了一个很好的特性:能够在for循环遍历map的时候直接使用结构化绑定,例如:

    #include <iostream>
    #include <string>
    #include <map>
    
    int main()
    {
      std::map<int, std::string> id2str{ {1, "hello"}, {3, "Structured"}, {5, "bindings"} };
    
      for (const auto& elem : id2str) {
           std::cout << "id=" << elem.first
                << ", str=" << elem.second << std::endl;
      }
    }

    End.

  • override和final说明符(C++11) 学习笔记

    重写、重载和隐藏

    重写(override)、重载(overload)和隐藏(overwrite)在C++完全不同的概念,先梳理一下区别:

    重写

    重写的意思更加接近于覆盖,在C++中是指派生类覆盖了基类的虚函数,这里的覆盖必须满足有相同的函数签名和返回类型,即重写是有相同的函数名、形参列表以及返回类型。

    重载

    它通常指一个类中有两个或者以上的函数,他们函数名相同,但是函数签名不同。

    隐藏

    隐藏的概念是指基类成员函数,无论是否是虚函数,当派生类出现同名函数时,如果派生类函数签名和基类不同,则基类的会被隐藏;如果派生类函数签名和基类相同,如果是虚函数则为重写,否则为隐藏。

    如果想在子类中使用基类的函数,可以使用using关键字将其引入派生类。

    override: 重写的问题

    重写容易出现问题,即基类定义了虚函数,但是子类的函数名写错了,也不会有编译错误,只有运行测试时才会发现错误。

    因此C++引入了一个非常实用的关键字,即override,这个关键词告诉编译器,这个函数需要覆盖基类的虚函数,一旦编译器发现虚函数不符合重写规则,就会报错。

    final说明符

    在C++引入了final关键词来阻止派生类继承虚函数。它告诉编译器,这个函数不能被重写,如果重写了会编译报错,跟override一样放在函数声明的尾部。

    End.

  • C++ 11/17强枚举类型读书笔记

    强枚举类型

    原来继承自C语言的枚举类型在C++之父看来是一个奇怪且半生不熟的概念。

    枚举的弊端

    虽然枚举类型可以避免A类型赋值给B类型,但是:

    • 可以直接跨枚举比较
    • 可以直接转化为int
    • 同名的枚举值是冲突的

    虽然有很多缺点,但依然是建议使用枚举而不是const int来做枚举,那样问题只会更多。

    强枚举类型

    C++11标准增加了强枚举类型,为了保证老代码的兼容性,同时也兼容了旧的特性,新增的枚举类型具有三个特性:

    • 枚举标识符属于强枚举类型的作用域。
    • 枚举标识符不会隐式转换为整型。
    • 能指定强枚举类型的底层类型,底层类型默认为int类型。
      基本上就是让枚举不是一个int的别名,而是一个独立的完全定义,具备完全语义的类型,同时解决了枚举值作用域的问题。

    为了兼容旧的逻辑,所以使用了新的标识符,从enum替换成了enum class。

    列表初始化有底层类型枚举对象

    这一段真的很难理解,为什么C++标准要搞这种东西,即使书里面有一些解释,我还是觉得不太理解…
    首先强枚举类型支持由int作为参数的列表初始化:

    enum class Color {
     Red,
     Green,
     Blue
    };
    int main()
    {
     Color c{5};
     Color c1 = 5;
     Color c2 = {5};
     Color c3(5);
    };

    这个例子真的震惊到我,Color的范围不是[0~2]吗,怎么就能赋值成5?
    而且{5}和(5)的差别是列表初始化构造函数和参数构造函数,为什么要有这种奇怪的特性?C++真的越来越折磨人。。。
    说是为了定义一种特殊的整数类型,同时这个整数类型不能跟其他的整数互相转换,强枚举类型符合这个特性,所以通过列表初始化构造函数让强枚举类型变成了一种非通用整数类型的整数类型。
    C++真的越来越折磨人。。。

    用using打开强枚举类型

    可以使用using namesapce;的方式,省略掉强枚举类型的前缀,直接在上下文使用枚举值。

    enum class Color {
     Red,
     Green,
     Blue
    }
    const char* ColorToString(Color c)
    {
     switch(c)
     {
      case Color::Red: return"Red";
      case Color::Green: return"Green”
      case Color::Blue: return"Blue";
      default:
        return"none";
      }
    }

    可以改成:

    enum class Color {
     Red,
     Green,
     Blue
    }
    const char* ColorToString(Color c)
    {
     switch(c)
     {
      using Color;
      case Red: return"Red";
      case Green: return"Green”
      case Blue: return"Blue";
      default:
        return"none";
      }
    }

    End.

  • 记录几个git的知识点

    git

    我们项目用svn比较多,最近在做一些git的尝试,之前对git一知半解,属于能用但不太懂,仔细看下来确实git比svn复杂不少。

    rebase和merge的差异

    参考文章:

    1. https://blog.csdn.net/u010698107/article/details/129000177
    2. https://dingjingmaster.github.io/2022/05/0002-rebase%E4%B8%8Emerge%E7%9A%84%E5%8C%BA%E5%88%AB/

    是用git的开发方式通常是这样:
    file
    从master分支拉取一个自己的开发分支,然后自己会开发对应的内容,开发完成之后通常其他人也对master进行了提交,这个时候就会出现这样的分支情况:
    file
    我在feature分支肯定不能直接提交在master分支上了,这里就有两个思路,一个是把master最新的两个提交C3, C4也merge到C6这里,进而产生一个新的提交,如下所示:
    file
    这就是merge,但是对于git我们通常不这么干,我们通常做的事情是rebase,即将c3, c4的提交插入在C5之前:
    file

    上面这就是rebase和merge的差异。
    但是有一个很重要的协作法则,rebase不要用在公共协作分支上。如第二篇参考文章中提到的,如果我rebase了一个公共分支之后,其他同学在这个分支上也有提交,那么彼此之间就需要大量的merge而且混乱,那不如直接merge。

    pull和fetch的差异

    简单地说git pull包含了git fetch && git merge。
    git fetch主要是为了从远程仓库获取最新的代码,例如将仓库的代码拉到origin/master中,这个操作不会影响本地分支,通常git fetch之后还要做一些其他的工作,例如rebase,merge之类,所以开发了一个简化的指令pull。

    git pull就基本上是等价于快速地进行一次合并,所以默认行为是merge,可能需要手动处理冲突,同时也可以在pull中使用–rebase参数将merge操作改成rebase操作:

    git pull origin master  # 相当于git fetch origin master + git merge origin/master current_brance
    git pull --rebase origin master # 相当于 git fetch origin master + git rebase master

    所有参考文章:

    https://blog.csdn.net/u010698107/article/details/129000177
    https://dingjingmaster.github.io/2022/05/0002-rebase%E4%B8%8Emerge%E7%9A%84%E5%8C%BA%E5%88%AB/#git-rebase-%E5%8E%9F%E7%90%86
    https://cloud.baidu.com/article/3318148

    End。