分类: 算法

  • [Asio] 学习笔记1. 初识asio和tcp

    打算基于asio写多种序列化库的测评,在底层用同一个asio构造函数的方式,然后上层测试脚本里切换序列化的实现。
    但是最开始按着demo写逻辑就出现了问题,我想先纯面向过程,就没像demo里写一个connection类,然后就探究到一直会闪退的问题。

    最后定位到时ip::tcp::socket析构的时候会断开连接。

    socket的析构会断开连接

    socket的大概是这样的结构:

    typedef basic_stream_socket<tcp> socket;
    template <typename Protocol, typename Executor>
    class basic_stream_socket
      : public basic_socket<Protocol, Executor>;
    {};
    
    template <typename Protocol, typename Executor>
    class basic_socket: public socket_base
    {
    // ....
      ~basic_socket()
      {
      }
    
    #if defined(BOOST_ASIO_WINDOWS_RUNTIME)
      detail::io_object_impl<
        detail::null_socket_service<Protocol>, Executor> impl_;
    #elif defined(BOOST_ASIO_HAS_IOCP)
      detail::io_object_impl<
        detail::win_iocp_socket_service<Protocol>, Executor> impl_;
    #elif defined(BOOST_ASIO_HAS_IO_URING_AS_DEFAULT)
      detail::io_object_impl<
        detail::io_uring_socket_service<Protocol>, Executor> impl_;
    #else
      detail::io_object_impl<
        detail::reactive_socket_service<Protocol>, Executor> impl_;
    #endif
    };

    大概是这样的关系,虽然basic_socket, basic_stream_socket和tcp都没有在析构函数里做逻辑。但是实际实现操作系统连接句柄的impl_的析构函数里有做逻辑的,而且实现的方式还挺巧妙。
    Windows的io_uring_socket_service和Linux的reactive_socket_service都没有在析构里做逻辑,这一部分是在detail::io_object_impl里做的。

    template <typename IoObjectService,
        typename Executor = io_context::executor_type>
    class io_object_impl
    {
    public:
      typedef IoObjectService service_type;
      // Construct an I/O object using an executor.
      explicit io_object_impl(int, const executor_type& ex)
        : service_(&boost::asio::use_service<IoObjectService>(
              io_object_impl::get_context(ex))),
          executor_(ex)
      {
        service_->construct(implementation_);
      }
    
      // Destructor.
      ~io_object_impl()
      {
        service_->destroy(implementation_);
      }
    
    private:
      // The service associated with the I/O object.
      service_type* service_;
    };

    也就是io_object_impl本身实现的是IoObjectService的生命周期管理,对操作系统的io对象进行统一的封装,给上层提供统一的接口。然后通过模板类可以切换实际实现的方式。

    同时如小标题所示,ip::tcp::socket这类对象在析构的时候会断开连接,所以在asio实际使用过程中,一定要抓住socket的生命周期。

    ip::tcp::socket

    顺便深入看一下tcp的连接实现细节,我们以Linux的视角看一下实现细节。

    socket_base

    我们从最底层看起,basic_socket继承自socket_base,socket_base是一个定义了全双工半双工状态,当前等待状态的抽象类。它的抽象体现在析构函数实现在protetecd里,只有子类对象可以被析构。

    class socket_base
    {
    public:
      /// Different ways a socket may be shutdown.
      enum shutdown_type
      {
    #if defined(GENERATING_DOCUMENTATION)
        /// Shutdown the receive side of the socket.
        shutdown_receive = implementation_defined,
    
        /// Shutdown the send side of the socket.
        shutdown_send = implementation_defined,
    
        /// Shutdown both send and receive on the socket.
        shutdown_both = implementation_defined
    #else
        shutdown_receive = BOOST_ASIO_OS_DEF(SHUT_RD),
        shutdown_send = BOOST_ASIO_OS_DEF(SHUT_WR),
        shutdown_both = BOOST_ASIO_OS_DEF(SHUT_RDWR)
    #endif
      };
      // ....
    protected:
      /// Protected destructor to prevent deletion through this type.
      ~socket_base()
      {
      }
    };

    basic_socket

    template <typename Protocol, typename Executor>
    class basic_socket
      : public socket_base
    {
      detail::io_object_impl<
        detail::reactive_socket_service<Protocol>, Executor> impl_;
    };

    这个对象是对套接字做的一个高级抽象,类似于Linux里万物都是socket,可以read and write,具体的上层协议本身是定义在Protocol里面,Protocol包含协议本身以及endpoint,也就是地址。

    例如TCP的endpoint就是IP和地址,感觉如果未来KCP或者其他协议,可以直接定义一个新的endpoint类,增加多个channel就能实现很多东西,没必要用多个实际上的操作系统套接口?
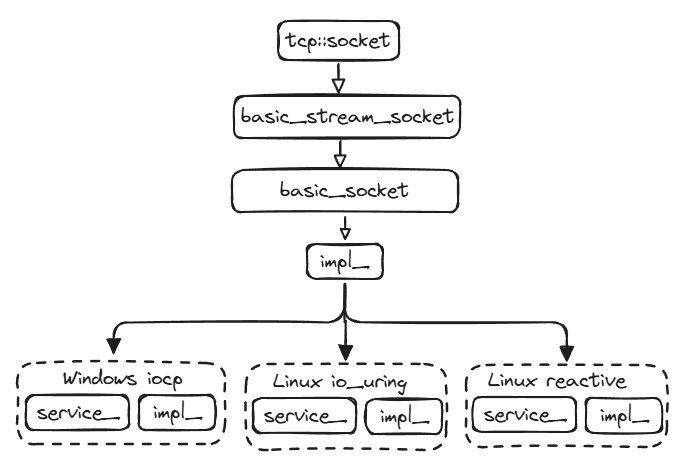
    这些实际操作系统的实现又落地在impl_里,impl_实际上是一个io_object,不同的系统会是不同的实现,但是保持统一的对外接口,大概如下图:
    file

    我们从最底下向上看,在每个操作系统底层其实有两个部分,service_和implement_,他们互为一组向上和向下的关系抽象,implement_是service_类里的一个struct,主要包含该操作系统API下的资源细节,通常包含套接口句柄,上层协议类型,以及其他的一些数据。
    例如在Linux下,所有的socket都是用int类型的一个句柄,无论是Tcp还是文件还是Udp协议都是同一个句柄。所以implement_里存了套接口以及具体的Tcp还是Udp协议。
    service_则是对操作系统的API提供的一层service抽象,将不同的操作系统的IO接口提供成统一的API,这里实现了创建、连接、收发消息和关闭连接。
    而整个service_会被basic_socket用作操作系统无关的io对象的实现,而基于这些,basic_socket向上层提供了连接和异步的基本能力,创建、管理、异步等待等…
    再进一步basic_stream_socket则是向上层提供了进一步的读写能力。

    本次就先读到这里吧。

    End.

  • 用python理解C++20协程的设计

    C++20拥有一个全新的特性:协程。

    我来从python的角度来解释C++这个特性设计与其他语言的不同,目的以及意义。

    协程是一种可以挂起和恢复执行的函数。C++20协程跟python的生成器是很相似的,如果函数中出现了co_yield, co_return, co_await,那么这个函数就是协程函数。而协程的本质就是将一个函数拆分成多个不能控制执行顺序,但是可以控制执行时机的语言结构。

    对普通函数而言,执行一个函数是开始运行你的逻辑;但是对于协程来说,执行协程函数会先创建一个协程对象,但是是否开始执行还是挂起是视情况而定的。

    例如这个python代码:

    def hello():
        print("Start run")
        ret = yield2
        print("After suspend", ret)
        yield3
        print("After Suspend")
    
    def main():
        generator=hello()
        print(generator)
        ret1 = next(generator)
        print("ret1: ", ret1)
        ret2 = generator.send(23)
        print("ret2: ", ret2)
        generator.send(23)

    在这里hello就是一个协程函数,执行之后会获得一个generator,对generator执行send或者next才会开始真正的执行协程逻辑,从头或者从上次执行的地方一直直行到下一个yield,然后再挂起返回给外面。

    python的生成器跟C++协程很像,都是无栈协程,但是C++的更复杂,因为C++是需要自定义协程对象。
    例如这个简单的C++逻辑:

    TaskCoroutine task_func() {
        std::cout << "task first run" << std::endl;
        co_yield 6;
        std::cout << "---before await task2---" << std::endl;
        co_await task2();
        std::cout << "task resume" << std::endl;
        co_return 3;
    }
    
    int main() {
        std::cout << "Before task_func" << std::endl; 
        TaskCoroutine load_task = task_func();
        std::cout << "After task_func" << std::endl;
        load_task.resume();
        std::cout << "After resume" << std::endl;
        return 0;
    }

    这里因为有co_yield,所以task_func是一个协程函数,但是跟python不同,C++需要定义携程的返回类型,是一个自定义类型,代表的这个携程的Task或者Coroutine。

    这个类型类型必须包含promise_type名字的PromiseType类,例如:

    struct TaskCoroutine
    {
        using promise_type = PromiseType;
    }

    没有这个那编译就会异常,感觉这个是类似于C++20的概念约束做的。

    promise_type又是另外一个约束的类,必须拥有几个必须定义的函数,以及几个可选定义的函数:

    struct PromiseType {
        PromiseType()
        {
            std::cout << "PromiseType" << std::endl;
        }
        TaskCoroutine get_return_object() {
            std::cout << "get_return_object" << std::endl;
            return TaskCoroutine{std::coroutine_handle<PromiseType>::from_promise(*this)};
        }
        std::suspend_never initial_suspend() noexcept {
            std::cout << "initial_suspend" << std::endl;
            return {};
        }
        Awaiter<true> final_suspend() noexcept {
            std::cout << "final_suspend" << std::endl;
            return {};
        }
        void unhandled_exception() {
            std::cout << "unhandled_exception" << std::endl;
        }
        std::suspend_always yield_value(int x) noexcept {
            std::cout << "yield_value" << std::endl;
            return {};
        }
        void return_value(int x) noexcept {
            std::cout << "return_value" << std::endl;
        }
    };

    剩下的内容实在是不想写了,看我的视频吧:
    https://www.bilibili.com/video/BV1H66aYTE84

  • 默认和删除函数(C++11)笔记

    类的特殊成员函数

    在C++中定义一个类,会默认生成以下6个成员函数:

    • 默认构造函数
    • 析构函数
    • 复制构造函数
    • 复制赋值运算符函数
    • 移动构造函数(C++11 新增)
    • 移动赋值运算符函数(C++11 新增)

    这些功能很实用,在我们直接定义一个类之后,能够直接互相拷贝,而不用为了编译器语法的原因一定要写一遍这些函数。

    但是它也有一些潜规则:

    • 声明任何构造函数都会抑制默认构造函数的添加。
    • 一般用自定义的构造函数替代默认构造函数,类就会转化为非平凡类型。

    非平凡类

    什么是平凡类什么是非平凡类呢?
    这里的概念是出自C语言,C语言想要复制一个对象最快速的方法是直接把整个对象的内存从a复制到b,而不用考虑其他的情况。

    但是对C++的类,可能就不能通过直接复制对象的内存来实现复制,因为类可能定义了构造函数、复制构造函数,要在直接的内存copy之前或者之后做一些逻辑,甚至可能是很重的逻辑,那么对象的拷贝就只能通过复制构造函数来做了。

    因此,平凡类和非平凡类的最大差别是:是否能直接copy类的内存块来实现完整的复制,想做到这个要求这个类在构造的时候和复制的时候不需要做额外的逻辑,但是编译器无法确认你是否有做了额外的逻辑,所以编译器只能定义,显式(explict)定义了四种函数:

    • 构造函数
    • 复制构造函数
    • 复制赋值函数
    • 析构函数
      有另外定义就是非平凡类,但是如果定义了使用=default,也算是默认的,所以不会改变平凡类的性质。

    从我这个角度去分析这个问题应该会简单一点。

    POD是指完全跟C语言的struct兼容,需要是平凡类和标准布局,这俩分别对应的是行为定义和内存定义。

    显示默认和显示删除

    C++11标准提供了一种简单的方法能够有效地控制默认特殊函数的添加和删除,语法很简单,就是在尾部添加=default和=delete。

    这里=default可以在.cpp中去制定,但是=delete必须在.h中指定,不过这个也很好理解。

    显示删除除了在这些地方,还可以使用在普通函数上,可能是给一些库使用,保留旧的函数签名,但是链接新版本时会失败,虽然听起来还是没什么用。

    然后就是可以显式的删除new函数和析构函数,而且这两者的表现完全相反,new操作符被删除之后,就不能通过new创建了,只能通过自动变量、静态变量等方法创建;而析构函数删除后,则无法调用delete函数,同时也无法从自动变量、全局变量中创建。

    参考了一下维基百科里C++的new,原来C++ new一个过程是先用operator new创建内存,然后调用构造函数再返回指针,而new 操作还支持在已经有的内存上直接new一个对象……

    参考

    https://zh.wikipedia.org/wiki/POD_(%E7%A8%8B%E5%BA%8F%E8%AE%BE%E8%AE%A1)
    https://zh.wikipedia.org/wiki/New_(C%2B%2B)

    End。

  • 树状数组学习笔记

    树状数组

    推荐文章:https://leetcode.cn/problems/range-sum-query-mutable/solutions/2524481/dai-ni-fa-ming-shu-zhuang-shu-zu-fu-shu-lyfll/
    推荐视频:https://www.bilibili.com/video/BV1ce411u7qP/?vd_source=9916020e44ecb0118b4b1ad9cd262997

    总体功能上来说就是一个快速对区间进行求和和修改的数据结构,推荐文章里讲的真的很好,想要查的快多做缓存能到O(1)的效率,但是修改就会是O(n)的效率,那树状数组就是综合查找和修改的一个数据结构,能做到O(logn)的效率。
    具体的算法细节就不再多赘述
    是一个真的很好用的工具!

    我专项的做了一些训练,出题的人还是挺厉害的,树状数组本身是求下标之间数量和的结构,但题目里的使用场景被扩充到了求某一些值之间的数量。

    具体变换

    求某些值之间的数量

    题目:将元素分配到两个数组中 II

    这个题目是一个模拟题,但是题目核心的复杂度在greaterCount函数的实现,如果直接遍历O(n)的复杂度,那么这个题目最大的复杂度就去到了O(n^2),肯定是不够快的。

    那有什么结构能够快速实现数组内大于等于某个数量的查询和插入呢?

    答案:树状数组。

    离散化
    那要怎么做呢?将数组内的值作为横坐标,每个数据的纵坐标都是1,也就是创造了一个记录值数量的结构,那么对[1, 5]求和就能够表示:在原数组内值为1~5之间的总数,这就能够满足原问题了,但这会引入一个新的问题:

    3 <= n <= 10^5
    1 <= nums[i] <= 10^9

    那就是树状数组的坐标会变得非常大,这时就有另外一个办法,我们将原数组进行一次离散化的压缩,例如:
    100, 701, 504, 10201
    可以被压缩成:1,3,2,4,其中需要记录1~100, 2~504, 3~701, 4~10201
    它也可以被压缩成:1,2,3,4,其中1~100, 2~701, 3~504, 4~10201
    这二者有什么差别吗?前者保留了映射数组的大小关系,但代价是一次O(nlogn)的排序,我们需要的当然是前者,但后者也是离散化。

    >, >=, <和<=

    题目:通过指令创建有序数组

    树状数组很像是一个公式,它的公式本身只能求解<=值的数量,但是如何扩展到另外四个维度呢?

    小于等于: 原本公式化的Get(v)即可;
    小于: 原本公式化的Get(v-1)即可;
    大于: 当前总数 – Get(v)
    大于等于: 大于 + num[v]

    置换

    题目: 统计数组中好三元组数目

    原本的题目是比较复杂的,明显是需要遍历A数组,找到三个数(a,b,c),然后在B数组中寻找a,b,c是否存在,且仍然保序。

    置换是一个排列到另一个排列的双射。所有全排列的数组之间求前后顺序相关的题目都可以考虑这个方案。
    置换即直接将AB数组做一个关于A数组的坐标映射:

    A: [2,0,1,3], B: [0,1,2,3]
    映射成:
    A: [1,2,3,4], B: [2,3,1,4]
    
    A: [4,0,1,3,2], B: [4,1,0,2,3]
    映射成:
    A: [1,2,3,4,5], B: [1,3,2,5,4]

    因为做了置换,问题就从要在A, B中寻找一个三元数,变成了在B数组中找三个升序排列的子数组总共有多少个。
    如何遍历呢?
    三元数是(a, b, c),只需要在B数组中遍历b就可以,然后在左边寻找有小于b的数量x,右边是否有大于b的数量y,sum(x * y)就是结果。
    接下来的问题就是如何快速求解左边小于b, 右边大于b的数量呢?
    依然是遍历,从左到右维护一个树状数组的结构,在遍历过程中就可以快速求解<x的数量,那如何求右边是否有>x的数量呢?因为是全排列,总共会有(n-x)个大于x的数量,那左边有l个的话,右边就有n-x-l个,综上。

    额外的知识

    离散化

    离散化的方案其实很简单,就是排序之后做一个映射,但是可以直接对有序数组进行遍历,无需关心是否是完全连续,只需要保证离散化之后的坐标保留值本身的大小关系,代码如下:

    sort(sortedNums.begin(), sortedNums.end());
    unordered_map<int, int> indexMap;
    for(int i = 0; i < sortedNums.size(); i++)
    {
        indexMap[sortedNums[i]] = i + 1;
    }

    lower_bound

    看到其他人的题解里用到了std::lower_bound,深入看了一下,参考文章。

    除了lower_bound,标准库还包含upper_bound, equal_range和binary_search这4个查找函数,底层都是二分查找。

    在那些同学的实现里,就是用这个替代前一小节的indexMap的映射关系。我的实现是用O(n)的时间建立了一个unordered_map,换取每次O(1)的读取。而他们的实现是不用O(n)的时间以及空间建立额外的哈斯表(unordered_map)或者红黑树(map),直接用排序的数组进行二分查找。

    这里C++标准库提供了四种查找:
    lower_bound: 左到右查找第一个大于等于目标值的元素的迭代器
    upper_bound: 左到右查找第一个大于目标值的元素的迭代器
    equal_range: 从左到右找出等于目标值的迭代器范围, [first, last)
    binary_search: 只返回是否存在,不返回迭代器

    同时我还挺惊讶的,直接用lower_bound似乎比用unordered_map要更快?是因为反复扩充hash表吗?

    vector::unique, vector::remove, vector::erase

    这里是需要注意的!
    vector::remove和vector::unique都对vector数组进行了改动,将待删除数组挪到了数组末尾,但并没有执行删除操作。可能是考虑到类似于栈的top和pop的读和删除的操作分离。

    所以想要实际删除需要:

    std::erase(std::unique(v.begin(), v.end()), v.end());
    std::erase(std::remove(v.begin(), v.end(), val), v.end());

    拆开的目的应该就是在删除之前还能保留一定读的能力。

    本节参考:
    https://blog.csdn.net/Vcrossover/article/details/106243627
    https://cloud.tencent.com/developer/article/1022341
    https://en.cppreference.com/w/cpp/algorithm/unique

    End.

  • SGU 101 Domino 翻译 题解

    101. 骨牌
    时间限制:0.5s
    内存限制:4096KB


  • tyvj 字符串的展开 解题报告

      纯水题,竟然花了我好几天的时间,真是无聊,我写了好久的代码!这个情况应付不了a-b-c,我的会转变成ab-c,唉,不解释不解释。很水,自己做吧,上代码(我的代码分层的思想可以参考一下,可能有点OO性质):

    (代码等下发)

  • RQNOJ 47 [NOIP2003]神经网络

    算法本质:SPFA 算法描述:网上有一些人的代码是错的,只怪NOIP这种破竞赛的难度太低,数据太差,导致他们都可以溜过去了,但是有不少人的代码都是不能够AC的代码,他们利用图的进度来判断是否能够加入SPFA的列队,那么特殊情况,当有一个神经节点无法发送信号时,它后面的所有节点不都死翘翘了,迟迟不能进入列队,你们可以测试一下这一组数据:de> 5 5 1 0 0 1 0 0 0 0 0 0 1 2 1 1 3 1 2 4 1 3 4 1 4 5 1de>   思路其实还是很简单的,就是一层一层的枚举,当入读为0就入列队,如果c[i]<0 ON code lang="C">#include #include #define MAX 200 int n, p; int f[MAX]; int map[MAX][MAX]; int link[MAX][MAX]; int lenth[MAX], in[MAX]; void add(int a, int b, int c) { link[a][lenth[a]] = b; map[a][lenth[a]] = c; lenth[a]++; in[b]++; } int queue[MAX]; int end, head; void enqueue(int i) { queue[end++] = i; } int exqueue(void) { return queue[head++]; } int main(int argc, char *argv[]) { int t, s, l; int i; scanf("%d%d", &n, &p); for(i = 0; i 0){ enqueue(i); }else{ f[i] = -t; } } for(i = 0; i 0){ printf("%d %d\n", i + 1, f[i]); l = 0; } } if(l){ printf("NULL\n"); } return 0; } de>